PGX 开卖已停止维护版本的 PostgreSQL 补丁
很多实例因为各种原因迟迟无法升级,却仍然需要打补丁。PGX 推出 PGX Longevity,为社区已经停止发版的 PostgreSQL 提供关键安全问题和数据完整性问题的回补,覆盖 9.6 到 13;PostgreSQL 14 在今年 11 月拿到最后一个社区版本之后也会纳入。计费按客户固定价格,而不是按实例或 CPU 核心数,并可提供服务级别协议。PGX 同时对所有版本提供包含升级在内的技术咨询。
pgsql.cc 提供对 postgresql.org 官网内容的中文翻译,由 Pigsty 团队维护。
每日精选 PostgreSQL、数据库与云计算资讯
很多实例因为各种原因迟迟无法升级,却仍然需要打补丁。PGX 推出 PGX Longevity,为社区已经停止发版的 PostgreSQL 提供关键安全问题和数据完整性问题的回补,覆盖 9.6 到 13;PostgreSQL 14 在今年 11 月拿到最后一个社区版本之后也会纳入。计费按客户固定价格,而不是按实例或 CPU 核心数,并可提供服务级别协议。PGX 同时对所有版本提供包含升级在内的技术咨询。
Stefan Aichholzer 把 Aurora PostgreSQL 上跑生产级 RAG 负载的经验写成一篇指南:HNSW 与 IVFFlat 怎么选,数据集小或已分区、需要百分之百召回时干脆别建索引;文中给出基准 schema,讲了距离算子选择、pgvector 0.8.0 的迭代扫描、用 halfvec 与二值量化省空间,以及靠 REINDEX CONCURRENTLY 处理 HNSW 碎片。
Hans-Jürgen Schönig 演示了用 PostgreSQL 19 的 SQL/PGQ 建异构图:一个属性图里同时有 person、company 两类顶点和 knows、works_at 两类边,跨表关系照常查。他也点出眼下的限制,MATCH 子句还不支持逗号分隔的多个路径模式,替代做法是把多个 GRAPH_TABLE 子查询按 ID 列连接。另有两个坑:多标签图里用匿名边会悄悄合并所有边类型,可变长度路径也还没实现。
Matty Stratton 说,把 TimescaleDB 自托管到关键业务上,本质不是一次数据库选型,而是一笔持续的平台工程投入。文章以一家每天采集数十亿条传感器数据的汽车零部件供应商为例,把可用性、恢复、扩展、生命周期管理和合规治理的实际成本逐项摊开:维持生产级部署大约需要 1.5 到 3 名专职平台工程师、稳定的值班轮换、每季度演练和每年一次大版本升级,而且随着数据量和业务重要性增长只会更重。
Shridhar Khanal 讲了怎么让灾备端通过 TLS 而不是 SSH 连 pgBackRest 仓库。好处是证书体系比逐台预置 SSH 密钥好管,且灾备机只持有一张认证到 TLS 守护进程的证书,被攻陷也拿不到备份节点的 shell。备份节点用 tls-server-auth 把证书 CN 映射到 stanza。注意 pgBackRest 不支持证书吊销列表,撤权得改配置重启;恢复出的实例还留着生产归档命令,启动前必须关掉。
PostHog 称重写 SQL parser 之后拿到 70 倍提升。具体倍数要结合负载来读,但它说明这类基础工程债确实能直接换成用户可感知的性能。SQL 解析器处在查询编辑器、权限分析、查询重写、语法高亮、自动补全、血缘和优化建议的入口,慢下来会拖累整条开发体验链路。维护数据库控制台、SQL 审计或 AI 生成 SQL 的团队,解析层应该有独立的基准和回归测试,而不是只靠数据库端报错兜底。
14 到 16 的最新小版本重放旧版本 WAL 时会死锁,多位用户已在流复制和恢复场景复现。
Nitin Jadhav 认同它只是一致性下限而非恢复进度指标,是否继续推进交给提案人决定。
争的是要不要保留 transaction ID space 这种说法,统一术语可能推到 v20 单独处理。
分组与去重的键顺序可由规划器重排,用户写的顺序始终保留为候选之一,升级后回退再查。
搜索、日志与可观测性栈的用户要重新评估供应商路线、许可与自托管迁移成本。
厂商称水耗接近零;散热、供电与机柜密度正成为集群规模的新上限。
仍是预览,把 IAM、VPC、CloudTrail 事件串起来之前,别让它直接触发破坏性响应。
泄露 token 与 CI 凭证横向移动时,响应速度直接决定影响范围,不必再走工单。
安全工具厂商同期收缩,开源基础设施商业化的压力正在集中显现。
平均值会误导容量规划,用集中度指标识别热点,同样适用于镜像站与对象存储。
表长到一定规模后,按时间戳排序的查询会突然变慢:同一条语句一千万行时约 180 毫秒,五亿行时要 4 秒,因为索引超出 shared_buffers 后退化成磁盘上的外部归并排序。TigerData 的办法是别再对原始行排序,仪表盘查询改用 time_bucket() 先聚合再排序,4312 毫秒能压到 9 毫秒,高频查询用连续聚合在写入时预计算。
Jeremy Schneider 建议为检查点的总耗时单独设告警:在 checkpoint_timeout 保持默认 5 分钟的前提下,他倾向把阈值定在 15 分钟。更稳妥的做法是监控距离上一条检查点消息过去了多久,这样连停摆到不输出消息的情况也能发现,同时对“检查点过于频繁”告警,那通常意味着要调大 max_wal_size。他特别提醒,检查点停滞时千万不要重启数据库,重启可能让实例陷入恢复循环,把几小时的故障拖成几天。
没人再查的数据和天天被查的数据占着一样贵的存储,bottomless Postgres 就是把冷数据挪到对象存储又让查询照常跨层。Shaun Thomas 回顾了几条路线:Neon 换掉整个存储引擎,pg_mooncake 把表镜像成 Iceberg,pg_lake 靠独立的 DuckDB 进程。ColdFront 则把 pg_duckdb 内嵌,归档分区后以 Iceberg 为唯一副本,用解析钩子改写 SQL 路由冷热数据。
Christophe Pettus 写了 cygnet,一个面向异步 Python 的 PostgreSQL 专用 ORM,要求 Python 3.12 与 PostgreSQL 14 以上。它的取向是透明而非省事:SQL 关键字写成大写方法,模型就是普通 dataclass,不需要继承或元类。UPDATE 和 DELETE 必须显式写 .WHERE() 才肯执行,避免全表误伤。JSONB、全文检索和 LATERAL 都是一等操作。
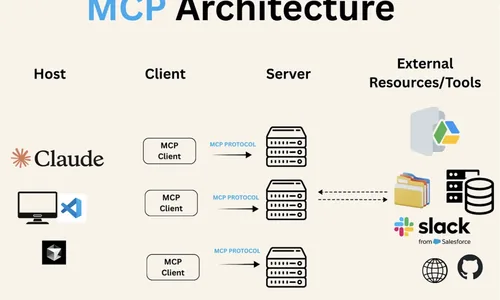
Stormatics 的 Warda Bibi 讲了怎么用 MCP 在 AI 智能体和 PostgreSQL 之间放一层受控接口,能力在代码里固定而不是靠提示词约束。文中用开源的 postgres-mcp,生产上应开受限模式,把语句包进只读事务并用 pglast 拦下 DROP TABLE。体检项包括膨胀索引、缓存命中率、空闲事务、事务 ID 年龄和复制延迟,索引建议靠 pg_stat_statements 加 hypopg 试算。
F3 是一个研究性质的列式数据文件格式,README 直说它只是验证论文想法的原型,不建议用于生产。它值得看的是设计方向:面向现代硬件和负载重构列式布局,并把解码器与数据本身绑定,让格式层能携带自描述元数据和可移植的解码逻辑。数据文件格式是湖仓、OLAP、数据交换和长期归档的底层协议,一旦这层能力变了,查询引擎、存储系统和兼容策略都要跟着调整。短期不必引入,中长期可以跟踪它的论文与基准测试。
后量子迁移不是升级一个库那么简单,它牵涉证书、TLS 终端、设备、客户端、供应商、合规,以及今天被抓走的数据在若干年后仍需保密这件事。Cloudflare 从大规模边缘网络的视角复盘了行政令给出的 2030 期限,讨论迁移步骤与目前的缺口。对基础设施团队来说,现在应该做的是盘点 TLS 终端、证书生命周期、依赖库、无法升级的老客户端,以及长期敏感数据的存放位置,而不是等到 2029 年再动手。
发布说明建议在下一个可用窗口升级,重度使用 hypertable 压缩的环境要先读变更列表。
排序、collation、TTL 和聚合累加器才是这类兼容层的关键路径,不能只测 CRUD。
Tomas Vondra 修正了 nodemask 大小与指针对齐,分区绑定与时钟扫描的收益仍不明显。
WaitEventSetWait() 的子函数退出前没清 PI_FLAG_SLEEPING,Heikki Linnakangas 已修。
Baji Shaik 的三个补丁分别挡下 epoch 之前、无穷大 interval 和超过 48 位毫秒的取值。
Tristan Partin 说动机是 UUIDv7 字典序与时间一致,取最早最新记录会方便很多。
争论点是 get_all_vacuum_rels() 里的提前权限检查该不该去掉,反正后面还会再验一次。
Peter Eisentraut 要求收窄讨论范围,先用一版补丁修掉这处空指针解引用。
自 REL_14 以来涉及 TAP 文件的提交约 172 个,两套框架并存意味着每次都要写两遍。
Agent Name Service 打算给智能体一套可信身份基础设施,把身份问题标准化。
random_page_cost 的默认值 4.0 来自机械硬盘年代,假定随机读比顺序读贵四倍。Tomas Vondra 在 POSETTE 演讲之后接着写道,SSD 与 NVMe 普及后随机 I/O 与顺序 I/O 的差距已经大幅缩小,这个默认值未必还合适。默认值偏高会让规划器系统性地低估索引扫描,做出更差的计划,他认为社区有必要重新评估并调整它。
CYBERTEC 发布 pg_hardstorage,一个 Apache 2.0 许可的 PostgreSQL 备份恢复工具。Hans-Jürgen Schönig 说它不打算取代 pgBackRest、Barman 或 WAL-G,而是面向 Kubernetes、托管云和混合基础设施这些新部署形态的社区驱动选项。设计上参考了复制协议,重新审视了传统增量备份链的固有问题。项目主页是 pghardstorage.org。
pg_clickhouse 让 PostgreSQL 直接查询 ClickHouse。David Wheeler 发布的 0.3.2 加上对 PostgreSQL 19 Beta1 的支持,同时保持对旧版本的兼容。CREATE SERVER 新增 secure 与 min_tls_version,可强制 TLS 并指定最低版本;修正了正则标志下推的映射,解决了无缓冲 HTTP 查询与参数化外部扫描的内存问题。升级不需要重启。
enable_async_append 默认打开,决定规划器是否考虑异步 Append,对应计划里的 Async Foreign Scan 节点。它是 PostgreSQL 14 为 FDW 分片加的:跨多个远端服务器的分区表或 UNION ALL 查询可并发发请求,总耗时从各分片延迟之和变成最慢分片的延迟。但它还要外部服务器上的 async_capable 为真,而后者默认关闭。Christophe Pettus 建议生产上保持打开。
EDB 发布 EDB Postgres AI 的 2026 年 Q2 版本,一次给出十项新增或增强能力,主线是把 AI 智能体从实验推到生产。其中包括会自行加索引、扩容和打补丁的 Agentic Database,基于 Apache Iceberg 的零 ETL 融合分析,正式可用的 EDB PG AI for ClickHouse,以及用原生角色和行级安全在数据库层管住智能体访问的治理预览。
AWS 推出 Lambda MicroVMs,基于 Firecracker,官方称它是一种提供虚拟机级隔离、近乎瞬时的启动与恢复、并能保留状态的无服务器计算原语。每个 MicroVM 有自己的 HTTPS 地址,可以挂起再恢复,最长八小时,支持 HTTP/2、gRPC 和 WebSocket,适合给每个用户或每个任务单独一个执行环境的多租户场景。镜像从 Dockerfile 构建,先在五个区域可用,按基线算力计费,超出部分另算。
startup 进程里 WAL 应用的 CPU 占比从约 47% 升到 89%,纯内存 pgbench 负载快约三成。
Peter Geoghegan 改为新增 INDEX_PAGES_LIMIT,只数返回空结果的叶页,对备库没有影响。
opr_sanity 用 != 比较让 NULL 掩盖了问题,改成 IS DISTINCT FROM 后暴露出四处不匹配。
Heikki Linnakangas 顺手修掉一个理论竞态:旧 worker 的结果可能被当成新一轮的。
VACUUM 必须清掉处理过页面上的全部死亡 TID,跳过幽灵页会导致 TID 回收出错。
Fujii Masao 提交补丁补全,争论点是要不要把逻辑放进通用的 plain_crypt_verify()。
Peter Eisentraut 完成提交,此前 Michael Paquier 已放话无人回应就自己动手。
Timothy Steward 面向迁移中的医疗与金融行业,讲怎么在性能与合规之间搭安全框架。
小版本号下藏着实质能力变化,升级前要读发布说明确认破坏性改动与兼容性。
hyper 是 Rust HTTP 生态的核心组件,代理、网关、服务网格和边缘平台都建在它上面。
托管服务开始内置运维助手,能访问哪些指标、能否直接改配置仍要看具体文档。
默认动作变化会影响长连接与连接池,经过它的数据库链路要观察重置和超时。
Tiger Geocoder 从 PostGIS 主库拆出来独立发布,版本号按发布时的美国人口普查 TIGER 数据年份命名。2025.1 载入 TIGER 2025 数据,最低要求 PostgreSQL 16,代码搬到 OSGeo Gitea 上的独立仓库;数据库搜索路径不再自动包含 tiger schema,需要自己配置。安全上给 schema 与表名加了引号,地址规范化支持按国家解析,高速公路编码认得 SH 与紧凑写法。
effective_io_concurrency 控制预取深度,含义随版本改过两次。PostgreSQL 13 之前它要过一个调和级数公式,设成 10 实际只预取三页左右;13 到 17 就是并发 I/O 请求数;18 起它驱动 PostgreSQL 自己的异步 I/O,走 worker 进程或 io_uring,默认值也从 1 改成 16。Christophe Pettus 提醒不要跨大版本照搬旧值,SSD 上可以往几百试但必须实测。
规划器读的是 pg_statistic,pg_stats 是同一份数据的可读视图,由 ANALYZE 扫表汇总生成,大批量导入后建议手工跑一次。Richard Yen 讲了四个关键列:n_distinct(唯一列为 -1)、null_frac、correlation(物理与逻辑顺序的吻合度)和最常见值列表。直方图默认 100 个等深桶,可用 ALTER TABLE 调大统计目标,多列相关的偏差交给 CREATE STATISTICS。
waxsql 生成类型正确、语法合法但计算上毫无意义的 SQL,用来给查询规划器做模糊测试、验证解析器、造可复现的负载。它对每个表达式向内部目录询问什么能产生某个类型,因此产出的查询能通过解析分析和类型检查,而不只是语法正确。复杂度由一个 0 到 10 的旋钮控制,schema 与查询各有独立随机流,同一个种子在不同机器上产出相同结果。项目是纯 Python、无运行时依赖,自带语法、解析和 explain 三级校验。
Christophe Pettus 在 PostgreSQL wiki 上新开了一页 The PostgreSQL C Dialect,把写 C 扩展要知道的约定和惯用写法集中记下来,起因是他写第一个扩展时踩的坑。Tom Lane 表示赞赏,Bruce Momjian 在 Developer's FAQ 上加了链接。Roberto Mello 注意到文中破折号密集,问是否由 LLM 协助撰写、有没有用别的模型核对,截至讨论时无人回复。
启动读取流的时机改到第四次切换堆块,消除了 LIMIT 与 nestloop 半连接场景下的回退。
Alexander Lakhin 在 buildfarm 上发现,引入原子解 pin 的提交 5310fac6e0f 埋下了这次挂起。
copy_file_range 返回 0 是合法情况,Peter Eisentraut 建议把它直接当错误处理。
Haas 与 Freund 反对在等待事件热路径上加判断,主张改成定时器中断的自采样。
Jeff Davis 发现存在 tablesync slot 时提前返回失效,修复可能要回移到旧版本。
编辑器里的 SQL 支持长期依赖正则启发式规则,跳转和补全都不可靠。Gavin M. Roy 发布的 postgres-lsp 基于 tree-sitter-postgres 实现语言服务器协议,用真正的 PostgreSQL 语法解析 .sql 文件,提供诊断、语义高亮、符号大纲、跳转定义、查找引用、上下文补全和函数签名,还能按 river、dbt、pg_dump 等风格格式化。PL/pgSQL 函数体通过语言注入解析。
effective_cache_size 不分配内存,只告诉规划器 shared_buffers 加操作系统页缓存大约有多少可用。规划器据此用 Mackert-Lohman 公式估算索引扫描的物理读页数:值大意味着重复访问多半命中缓存,索引扫描显得便宜;值小则更倾向顺序扫描与哈希连接。默认 4GB,Christophe Pettus 建议在数据库专用机上设成物理内存的 50%–75%,且必须大于 shared_buffers,宁高勿低。
按 Regina Obe 的说法,pgAgent 正在退场,半年后完全退役,pgAdmin 里的界面也会随之消失。她原先看重的是它跨 Windows 与 Linux、界面内建在 pgAdmin 里、后端就是 PostgreSQL 数据库,一个作业还能包含多个有序步骤。这一篇讲迁移动机并介绍替代品 pg_timetable,第二篇讲怎么在 Linux 上把它配成服务;她还在 GitHub 上做一个仿 pgAgent 的管理界面。
Justin Pryzby 发现合并出的表落到默认表空间,Alexander Korotkov 提交补丁对齐建表逻辑。
Amit Kapila 主张插入失败应报 ERROR,vignesh C 发现并发改订阅会静默丢掉冲突记录。
Rui Zhao 指出旧集群里用户自建的 origin 会跳过前置检查,升级到 restore 阶段才失败。
修掉 DEFINE 求值的 use-after-free、导航函数命名空间冲突和一个休眠匹配的正确性缺陷。
HypoPG 为 PostgreSQL 9.2 以上版本提供假设索引,可以在不真正建索引的前提下评估索引对执行计划的影响。Julien Rouhaud 发布的 1.4.3 修复了一个长期存在的 Int8GetDatum 缺陷,并补上对 PostgreSQL 19 的兼容,两项改动都由他本人完成,报告缺陷的用户列在 CHANGELOG 里。做索引调优的团队可以直接升级,源码与发布包在 GitHub 仓库获取。
dynamic_shared_memory_type 决定 PostgreSQL 启动之后用哪种内核机制分配共享内存,并行查询的运行期空间由它管理。Christophe Pettus 建议保持平台默认,Linux 上是 posix:sysv 受制于陈旧的内核限制,mmap 会把进程间内存变成磁盘 I/O,都只为老平台和调试保留。容器里 /dev/shm 默认只有 64 MB,并行查询会报共享内存无法扩展,正确做法是调大容器共享内存。
多态关联用一个判别列把基表指向多张子类型表,规划器会为每行探测 N 张表,只有一次连接真正命中,规模上去后出现性能悬崖。Andrei Lepikhov 梳理了三条正在 pgsql-hackers 上讨论的改进:Result 过滤在进入内表之前先做单侧条件求值;排序下推把 ORDER BY 与 LIMIT 的排序放到基表扫描之上;SubLink 重定位把 EXISTS 转换出的半连接挪到被引用表附近。三者截至发文都尚未提交。
ClickHouse 以彩窗为喻纪念开源十年。Tyler Hannan 给出的数字来自项目自身:system.contributors 表当时列出 2632 位贡献者;截至 2026-03-19,GitHub 上 issue 与 PR 合计突破十万,27600 个 issue 关闭了 23016 个,71284 个 PR 关闭了 70362 个。文章还举了 cBioPortal 的例子,接入之后筛选查询从分钟级降到秒级。
AI agent 会自动执行部署、调试、查询和配置修改,继续复用长期 token 和共享账号会迅速积累安全债。Cloudflare 发布 Temporary Accounts,把 agent 的身份生命周期做成平台原语,让人类用户与自动化主体分开治理,凭证短期有效并可撤销。这与 MCP 的企业认证、GitHub Actions 触发权限收紧是同一条线索:AI 工具链需要身份、审计和回收机制,而不是只靠 API key 约束。
Michael Paquier 调整注释后只提交到 HEAD 未回移,并提交了第二个相关修复。
AI 让低质量 PR 的生成成本骤降,平台开始用限流手段保护维护者的注意力。
把一次性 PoC 变成能进 CI 的回归资产,扩展、镜像和控制面都可以照此收敛。
Local Zone 的服务覆盖、价格、配额与合规能力都要单独确认,不等同完整区域。
单区域探针会掩盖 DNS、CDN 与跨洲网络故障,多地点更接近真实用户体验。
持续 profiling 的采集与查询速度提升,feed 未给发布日期,需要按官方公告复核。
风险集中在权限、语义层、查询成本与幻觉,比聊天机器人更接近生产系统。
企业可以按人查看 AI 额度消耗,把成本归因和异常用量纳入工程治理指标。
涉及 B200 与相关 attention kernel,静默错误会直接影响训练与推理结果可信度。
推理侧的算法优化直接影响单位 token 成本和交互延迟,比模型榜单更有参考价值。
pgAdmin 团队发布 4 v9.16,共 64 项修复与新特性,最要紧的是七个漏洞 CVE-2026-12044 至 CVE-2026-12050:对话框模板与还原点端点的 SQL 注入、AI Assistant 事务绕过导致的远程代码执行、无需认证即可访问且含 pickle 反序列化的 SQL Editor 端点、泄露服务器凭据的存储型 XSS,以及多因素认证流程里的开放重定向。同时 pgAgent 宣布弃用,预计半年后移除。
Melanie Plageman 发出 checkpointer 写合并补丁的 v15。新增能力是普通后端和 background writer 写盘时,会在共享缓冲区里找目标块前后相邻的脏块,把写 IO 合并到 io_combine_limit 大小。在 IOPS 受限的环境下测试,pgbench scale 500、8 个客户端、上限 7500 IOPS,TPS 提升约三成,p99 延迟下降约七成半。这一版还补了 TAP 测试。
分区键设计不当,写入会全挤在一个分区上,其余分区几乎闲着。文章梳理了随之而来的连锁反应:B-tree 索引频繁更新、页面分裂加剧、WAL 生成量上升,autovacuum 在热点分区上持续满负荷。文中给出基于 pg_stat_user_tables 的诊断查询,用死元组比例和索引大小定位问题分区。两条出路是改成按时间的 RANGE 分区让写入自然分散,或改用 hypertable 并对旧数据启用列存压缩。
GitHub 调整了 Actions 里 pull_request_target 触发时检出代码的默认行为。这个触发器带着仓库写权限运行,一旦顺手检出外部 PR 的代码,发布令牌、包仓库凭据和云密钥就可能落到外部贡献者手里,是经典的配置陷阱,平台改默认值比逐个项目打补丁影响面大得多。用到 pull_request_target、workflow_run 或自托管 runner 的仓库仍应自查。
研究者发现 GitHub 上存在成规模分发恶意软件的仓库群。开发者习惯从搜索结果、README、issue 和 gist 里直接取安装脚本,当恶意仓库能批量生产之后,只看 star 数、只凭看起来像个正经开源项目已经不够用了。AI 编码工具如果会自动检索并引入代码,还会把这类风险再放大一层。构建脚本里的管道执行、来路不明的二进制、没有固定版本的依赖和临时建起来的仓库,都值得更严格的审查。
Suraj Kharage 重新变基并建了 commitfest 条目,测试覆盖 RETURNING、ON CONFLICT、分区表、触发器和可更新视图。
该数字是距回卷限制的剩余空间,而非可用事务 ID 数量,因为分配会更早在停止限制处终止。
运行时参数会以占位符发到远端导致 EXPLAIN 失败,方案是强制 generic_plan 并限制远端版本。
两条维护线同步出修复版本,均为常规 bugfix,没有破坏性变更。
触发权本身就是生产权限的一部分,组织模板应把它与环境审批、OIDC 角色和密钥暴露一起定策略。
仓库内的 agent 指令成了平台功能,风险在于指令漂移、注入,以及不同 agent 对同一文件的理解不一致。
没有发现明确的重大 CVE 或破坏性变更,但运行时处在集群底层,值得例行复核 release notes。
托管 Kubernetes 的控制面网络是安全评审重点,出站可控有助于满足私网与出口管控要求。
分区再均衡历来是高风险操作,启用前应在预发环境模拟扩容、热点分区和 broker 替换。
若打算用它承载备份或归档,重点看 ECC、热插拔、快照复制、监控与厂商锁定。
提出零接触 OAuth 方案,把 agent 接入的身份、令牌刷新与撤销收归集中治理。