一组 PgBouncer 进程把连接池吞吐提到 4 倍
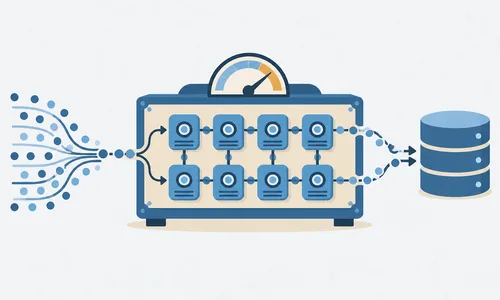
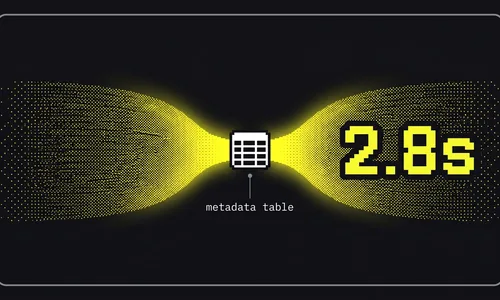
PgBouncer 是单进程单线程的,机器再大也只吃得下一个 CPU 核。Kaushik Iska 给出实测:16 vCPU 机器上单个进程约 8.7 万 TPS 到顶,单核占用 97%,整机利用率不到 10%。他们改成按核数起一组 PgBouncer 进程,用 so_reuseport 让内核做负载均衡,再在进程间做 peering 处理跨实例的查询取消。256 个并发客户端下这组进程跑到约 33.6 万 TPS,用满 8 个核。
pgsql.cc 提供对 postgresql.org 官网内容的中文翻译,由 Pigsty 团队维护。
每日精选 PostgreSQL、数据库与云计算资讯
PgBouncer 是单进程单线程的,机器再大也只吃得下一个 CPU 核。Kaushik Iska 给出实测:16 vCPU 机器上单个进程约 8.7 万 TPS 到顶,单核占用 97%,整机利用率不到 10%。他们改成按核数起一组 PgBouncer 进程,用 so_reuseport 让内核做负载均衡,再在进程间做 peering 处理跨实例的查询取消。256 个并发客户端下这组进程跑到约 33.6 万 TPS,用满 8 个核。
Neon 推出 Lakebase Search,由 lakebase_vector 与 lakebase_text 两个扩展提供向量和全文的混合检索。向量侧用 IVF 分区加 RaBitQ 量化,把向量压缩约 32 倍,索引可直接放在数据湖上,同时兼容 pgvector。文本侧不再依赖 GIN,改用原生 BM25 索引保存全库统计量,支持真正的相关性打分和 top-K 下推。两个索引面向对象存储而非常驻内存,现已开放。
pglayers 把 PostgreSQL 扩展做成预编译的 Docker 层:每个扩展发布成一个 FROM scratch 的镜像,在官方 postgres 镜像上用 COPY --from 一行叠一个。PostgreSQL 18 以上采用隔离布局,每个扩展放进各自的子目录,靠 extension_control_path 参数避免文件冲突。项目按 MIT 授权,目前支持 80 多个扩展,17 与 18 稳定,19 还是实验性的。
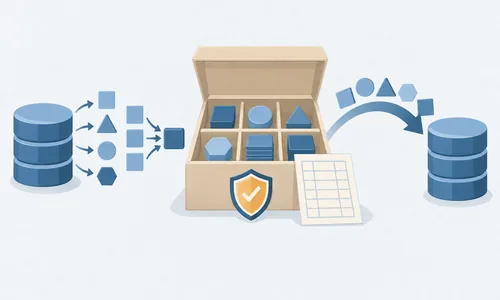
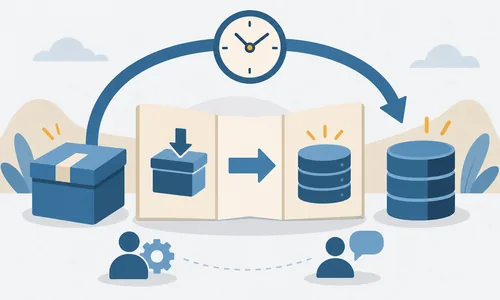
Cybertec 的 Hans-Jürgen Schönig 沿着一次备份的生命周期讲 pg_hardstorage:数据怎么被抓取、怎么进入仓库、怎么组织,最后又怎么在恢复时被拼回来。文章展开的是内容寻址存储、分块与去重、清单结构、元数据管理、完整性校验、损坏处理和垃圾回收这些机制,而不是操作手册。作者想说的是,备份跑成功只算一半,知道数据在系统里怎么流动同样重要。
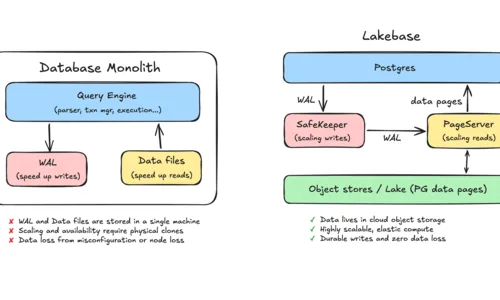
Databricks 的 Reynold Xin 提出 LTAP:在存储层而不是引擎层统一两类负载,让它们读同一份数据。Lakebase 把预写日志交给 SafeKeeper、数据文件交给 PageServer,从单体 PostgreSQL 里拆成独立的云服务,计算层因此无状态。PageServer 把页面落到对象存储时顺便转成列式 Parquet,并保留类型系统与多版本语义。厂商称写吞吐提高 5 倍、读延迟降低一半。
ClickHouse 26.6 的发布说明里列出了 hypothetical skip indexes、可级联刷新的物化视图,以及仍处于实验阶段的 continuous queries。方向是把分析数据库往自助优化、增量刷新和流式分析上推。对采用 PostgreSQL 加 OLAP 组合架构的团队来说,值得看的是物化视图刷新和连续查询能不能替掉一部分外部流处理组件。
Cloudflare 开放 Monetization Gateway 的等待列表,允许对放在 Cloudflare 后面的网页、数据集、API 或 MCP 工具收费,用 x402 协议结算。AI 智能体会大量读取网页、API、数据集和工具,传统的广告与订阅模型未必适配机器流量,把计费放到边缘层会改变内容和 API 的商业模式讨论。如果自家文档、API 或工具将来要面向智能体访问,机器流量的授权、限流和计费策略得提前想清楚。
CNCF 的文章介绍 Kubernetes 的动态资源分配 DRA,称它已在 Kubernetes v1.35 达到 GA,NVIDIA 的 GPU DRA 驱动也进了 Kubernetes SIGs。AI 负载让设备调度变得复杂,DRA 之后 GPU 不再只是一个可数的资源,而可以有更细粒度的声明和分配方式。运行 GPU 或 AI 集群的团队值得跟一下 DRA、驱动和调度器生态的进展,别被旧的 device plugin 模型限住。
Álvaro Herrera 反对新增 DDL 语法,Andrey Borodin 建议改成 pg_drop_invalid_indexes() 函数。
MariaDB 允许但结果可能不一致,DB2 在定义阶段就禁止;作者给出运行时检查和只补测试两案。
选定待删槽位到锁定数据库之间的窗口里,用户新建的槽可能复用同一槽位而被误删。
用 CloudWatch Database Insights 建一个中心监控账号,把跨环境的看板与告警路由统一起来。
同批更新还有 ECS 部署熔断设置、Service Connect 区域感知路由和 CloudWatch 日志查询告警。
Craig Kerstiens 梳理了 PostgreSQL 19 Beta:REPACK CONCURRENTLY 把不加排他锁的表重组做进内核,不必再依赖 pg_repack;ALTER TABLE 新增分区的合并与拆分;逻辑复制补上序列值同步与 ALL SEQUENCES 发布;autovacuum 支持并行 worker,并新增 pg_stat_autovacuum_scores 视图;SQL/PGQ 让关系数据直接跑图查询。
Warda Bibi 复盘了一次事故:checkpointer 卡了几个小时。原因是 fsync 请求队列没有上限,在大 shared_buffers 和重写入负载下越涨越大,超过 1 GB 的内部分配上限后申请内存失败;checkpointer 捕获错误后不断重试,而两次尝试之间队列毫无变化,于是陷入死循环。13 到 16.9 都受影响,16.10 给队列加了一千万条的硬上限。临时办法是调小 shared_buffers。
Zhang Chen 从一次勒索软件事故讲起:PostgreSQL 每张表一个文件,加密整个数据目录时所有系统表文件同时受损,没有冗余可用。pg_class、pg_attribute、pg_type、pg_namespace 四张核心目录表加起来通常不到 50 MB,很容易被完整加密,恢复的第一步重建库结构就走不下去。客户那份 100 GB 的二进制备份文件头也被加密,取出的数据无法对应回具体的表。
pgEdge 的 Ahsan Hadi 开源了 pg-healthcheck,一个直接查询 PostgreSQL 系统视图的诊断工具,分 14 组共 180 多项检查,覆盖 vacuum 与膨胀、WAL 与复制槽、事务 ID 回卷、数据完整性、可见性映射不一致以及 Spock 集群指标。下载预编译二进制或自行构建,带上连接参数即可运行。项目采用 PostgreSQL 许可证,可用于商业场景。
PlanetScale 发布 Database Traffic Control,把治理能力放到数据库的访问路径上。数据库故障常常来自突发请求、写坏的查询或批处理任务,流量治理要解决的就是让数据库从被动承压变成主动防护。PostgreSQL 这边可以对照的是连接池与 pgBouncer、查询限流、角色级别的资源隔离,以及慢查询熔断这几类能力。
NVIDIA 介绍了 GPU 加速查询引擎的设计思路和 GQE 的相关能力。AI 让 GPU 普及之后,分析型数据库和查询引擎会继续尝试复用这些算力,真正的难点不在写 kernel,而在执行计划、数据布局和传输成本。做分析数据库选型时值得区分有 GPU 支持和端到端查询路径真的受益;对 PostgreSQL 生态来说,GPU 加速更可能先出现在外部引擎、FDW 和 ETL 路径上。
AWS 宣布 RDS 的 IAM 数据库认证支持更高的连接速率。很多团队想用 IAM 和短期凭证替换静态数据库密码,但认证路径的吞吐一旦不足,扩容、故障切换或连接池抖动时它就会变成瓶颈。在云上设计 PostgreSQL 或 MySQL 的 IAM 认证时,值得重新核对连接池配置、冷启动、failover 行为和认证速率配额;自建发行版也应该把认证面的容量纳入可用性模型。
Álvaro Herrera 认为补丁逻辑不够直观、极端情况下有风险,建议留出更多审查与测试时间。
Dean Rasheed 还计划把全局临时表上 TRUNCATE 的锁级别降到 RowExclusiveLock,避免阻塞。
Fujii Masao 推送了该补丁,使用 MD5 加密口令做密码认证时会发出警告。
文章展示了完整的工程过程,讨论集中在运行边界,这类沙盒适合做培训、文档和问题复现。
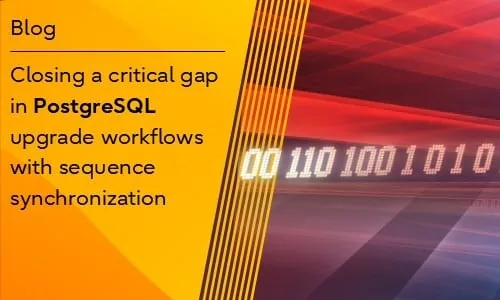
用 pg_createsubscriber 做在线升级时,表数据靠逻辑复制同步,序列取值却还是旧的,切换后很容易撞上重复键错误。PostgreSQL 19 把序列同步做进核心:序列可随表一起发布,由专门的同步 worker 把发布端状态复制到订阅端。发布时写 FOR ALL SEQUENCES, ALL TABLES,切换前再对订阅执行 REFRESH SEQUENCES。目前仍要显式加入发布并手动刷新。
Peter Eisentraut 报告了 6 月的斯德哥尔摩 SQL 与 GQL 标准会议。工作草案新接受四项提案:QUALIFY 在窗口函数之后过滤,INSERT BY NAME 按列名匹配,SELECT 列表的 EXCLUDE 去掉指定列,JOIN TO ONE 在运行时校验连接基数。PostgreSQL 这边 QUALIFY 在 19 周期暂停,预计 20 继续,EXCLUDE 已有部分实现。新标准计划 2027 年年中发布。
Laurenz Albe 说明了表太多的代价:一个后端访问过两万张表之后,relcache 与 catcache 从 4.1 MB 涨到 221 MB,pg_attribute 里堆了 94 万行。连带问题包括 autovacuum worker 起不来、pg_upgrade 从几分钟变成几天。这些缓存只增不减,他建议从设计上减少表数量,用规模适中的连接池,并在 v14 以上用 idle_session_timeout 清掉空闲会话。
Gulçin Yildirim 演示了用原生特性表达时态语义。PostgreSQL 18 起可以用 WITHOUT OVERLAPS 写出核心规则:同一业务键的有效期不能重叠,形如 PRIMARY KEY (id, valid_at WITHOUT OVERLAPS),重叠的会被直接拒绝。配合范围类型、带 PERIOD 的时态外键和 btree_gist,应用时间这一侧已经相当完整。系统时间的自动版本化和时间旅行查询还得靠触发器或扩展。
Percona Operator for PostgreSQL 引入 Community PostgreSQL Images:允许直接用 PGDG 官方软件包构建容器镜像,绕开厂商控制的镜像仓库,用户可用官方 Dockerfile 自行构建托管。它在 3.0.0 是技术预览,3.1.0 起正式支持,镜像内置 pgvector、pgaudit、pg_cron 等扩展。Percona 发行版的专有能力如透明加密 TDE 不在其中。
GitHub Security Lab 介绍了 Advisory Database 在漏洞数量创纪录时的内部处理方式和压力所在。对企业来说,真正决定修补效率的不是某一条 CVE,而是漏洞信息是否可信、及时、能被工具直接消费。维护开源包或内部发行流程的团队,除了确认扫描器有没有打开,更该关注公告的接入质量、误报的处理办法和依赖更新的节奏。
Chao Li 指出重写阶段只加载 UPDATE/DELETE 策略,于是可以靠更新子范围绕过 INSERT 策略。
标准明确展开时跳过窗口函数,与 PostgreSQL 现有行为一致,补丁同步更新了注释与文档。
与 TOAST 压缩的近期变更保持一致,多人赞成并建议放进 PG19,避免分两个版本切换默认值。
Fujii Masao 的评审指出文档遗漏、pg_upgrade 比较值写错,以及若干 pre-v10 的残留代码路径。
v8 补丁统一改用 try_table_open,评审建议把回归测试从 TAP 改成隔离测试。
v02 补丁系列 245 个回归测试全过,竞态对时序高度敏感,测试者未能复现原始问题。
回移到 18 和 17 需要微调测试;RangeVar 不该带 relpersistence 的重构问题仍待处理。
高噪声仓库可以启用,但要配套 discussion、安全公告或模板化渠道,别切断有效的缺陷报告。
文章举例说明小表怎么拖慢大查询:devices 表从 600 行长到 10000 行,pg_statistic 仍是旧数据,规划器于是选错 join 策略,改用嵌套循环代替哈希连接,原本 20 毫秒的查询变成好几秒。根子在 autovacuum_analyze_scale_factor 默认 0.2,增长缓慢的小表几乎不会自动触发 ANALYZE。办法有三种:单独调低该参数、手动 ANALYZE,或把稳定元数据冗余进事实表。
Richard Yen 在灾难恢复系列第二篇里说,处理得好的团队与手忙脚乱的团队,差别通常不在工具,而在演练过的流程。他给出三件具体的事:把 runbook 写成逐步操作,标明确切命令、成功标准、回滚路径和责任人;按难度递进做演练,先练恢复与切换,再加时间限制,再模拟关键人不在场;指定技术指挥和对外沟通两个角色,约定升级链路与授权门槛。他建议每月演练一次,记录各阶段耗时,把实际能达到的 RTO 与 RPO 和业务方对齐。
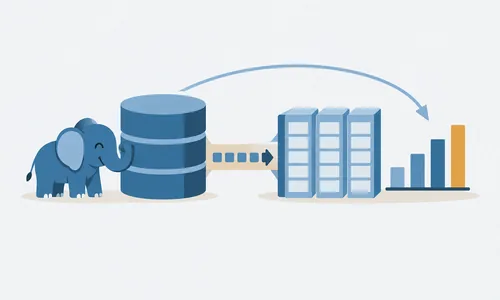
Lionel Palacin 给出一套全开源组合:PostgreSQL 作为记录系统,ClickHouse 承接分析负载,中间由 PeerDB 做变更数据捕获,再用 pg_clickhouse 扩展把查询下推过去。落地方式有两种,一种是 CDC 近实时复制数据,另一种是拆分写入,事件与日志直接进 ClickHouse,事务仍留在 PostgreSQL。仓库里给了可本地部署的示例配置,针对分析查询本身就是产品功能的场景。
Canonical 的 Marco Manino 与 Alberto Carretero 用 TLA+ 复查了 SQLite 里一个 2010 年就存在的数据损坏缺陷:检查点与写入并发地重置 WAL 文件时会发生竞态。他们为追加页面和检查点行为写了形式化规格,模型检查器很快找出触发问题的执行序列。SQLite 的修复办法是比较检查点前后的 WAL salt,变了就跳过。dqlite 不受影响,它在两种操作期间都持有写锁。
三星、SK 海力士和美光在美国被起诉操纵内存价格,同一天美光又预测 DRAM 短缺至少持续到 2028 年。数据库和 AI 基础设施都高度依赖内存容量与带宽,价格上行会直接传导到云实例账单、自建硬件预算和推理部署成本。做容量规划时,内存价格和供货周期值得作为单独的风险项列出;高内存的数据库节点、向量检索和推理缓存尤其需要提前锁预算或调整规格。
Riptides 的文章讲的是把 GitHub Actions 工作流里的长期 secret 删掉,让每个 job 拿到属于自己的短期身份,而不是共享一份长期有效的凭证。供应链攻击往往从 CI 里的 secret、包发布 token 和云凭证开始,静态密钥一旦泄漏,影响范围和有效期都不可控。发布包、构建镜像或部署云资源时,可以优先改用 OIDC 联合身份、短期 token 和最小权限角色,把凭证的生命周期压缩到单次运行之内。
SQL 标准已收录 QUALIFY,作者给出改写为子查询和让它成为 planner 一等构件两套实现供社区选择。
v7 补丁被指出与 ComputeXidHorizons 可能逐渐失步,恢复路径也没有考虑 KnownAssignedXids。
补丁被两位审阅者认为状态良好,等 committer 介入;争论点是 FIRST 与 ANY 是否都要保留去重测试。
Mihail Nikalayeu 把补丁基于当前代码重新变基,多位贡献者仍在审查,本轮没有新的设计变动。
可观测性与 etcd 生命周期管理是平台的底层能力,文中给出指标命名与来源的统一口径。
用五百万行 double precision 读数做演示:三次完全相同的查询分别得到 2500519211.7874823 和 2500519211.7874575 等不同结果。原因是并行聚合让多个 worker 以不确定的顺序抓取数据块,部分和的合并顺序随之变化,而 IEEE 754 浮点加法不满足结合律,每一步舍入都会改变结果。需要对账的金额类数据应当存成 numeric,它按精确十进制累加,与并行度和聚合顺序无关。
pgtt 为 PostgreSQL 提供 DB2 和 Oracle 风格的全局临时表,常用于 Oracle 迁移时不改应用代码的场景。HexaCluster 的 Gilles Darold 发布的 v4.5 是维护版本:新增对 PostgreSQL 19 的支持,支持 CREATE INDEX CONCURRENTLY,把全局变量改为 static 以消除编译警告,并修复了从转储恢复全局临时表目录时出现无效关系 OID 的问题。
Xata.io 把自家的云原生 Postgres 平台开源,采用 Apache 2.0 授权,用于在 Kubernetes 上自托管大量 Postgres 实例。底座是 CloudNativePG,之上加了 SQL 网关、分支 operator 与 serverless 驱动。写时复制让 TB 级数据的分支在几秒内完成,另有缩容到零、自动伸缩、读副本高可用和 PITR 备份。适合做内部 Postgres 服务平台,或开出预览与测试环境。
AWS 称为 MySQL 建立开放治理是社区向前的一步,VillageSQL 的文章则认为这是两步向前、一步向后:委员会是否握有实际决定权,还要看发布节奏、兼容性承诺、商标和贡献流程是否真的改变。MySQL 生态庞大,治理变化会一路传导到云数据库、分支发行版、企业标准和兼容层。同时维护 PostgreSQL 与 MySQL 的团队可以把这条线索留着,观察后续是否出现实质性的规则调整。
BleepingComputer 报道了一种针对 AI 编码助手的攻击:仓库本身看不出恶意代码,却能诱导助手在安装依赖或执行测试的环节运行恶意指令。AI 编码助手的默认行为正从读代码扩展到运行命令、装依赖、跑测试,原本只在开发者本机的风险被放大到自动化执行链路上。处理不可信仓库时应当默认隔离:禁用持久凭证、限制出网、清空环境变量、源码只读挂载,并在人工看过 install 与 test 脚本之后再执行。
Henson Choi 指出 v49 因 master 改了报错信息导致 cfbot 全平台报红,v50-0021 必须合入。
Álvaro Herrera 指出补丁措辞有误:refint 是 spi 这个 contrib 模块里的扩展,并非独立的 contrib 模块。
Rui Zhao 发现 schema_qualified=false 时缺少 token 边界检查,会改错跨 schema 的外键引用。
Amit Kapila 建议把 sent_bytes 改名为 output_bytes,并把 keepalive 等协议消息排除在统计之外。
AI 生成的 PR 与 issue 变多,审查成本落在人数没有变化的维护者身上。
GitHub 同时是协作平台、PoC 分发渠道和攻击者侦察面,这批漏洞的真实性仍需逐项复核。
把 checkpoint_timeout 调到一到五分钟,通常是为了缩短崩溃恢复时间。Lætitia Avrot 说这条推理站不住:恢复时长取决于要重放的 WAL 量,而不是这个参数本身;间隔越短,越多页面在检查点后首次修改时触发全页写,形成写放大。她建议多数负载放在 15 到 30 分钟,由 max_wal_size 按实际写入量触发检查点,可用性交给副本。调参之前先打开 log_checkpoints 看清现状。
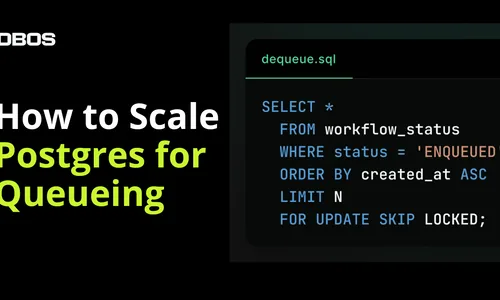
DBOS 的 Qian Li 与 Peter Kraft 说明了 Postgres 队列的扩展办法:上千个 worker 轮询同一张队列表会造成锁竞争和索引抖动,未优化时吞吐只有每秒百来个任务。三项改动是:出队用 FOR UPDATE SKIP LOCKED 各取各行,事务从 REPEATABLE READ 降为 READ COMMITTED 消除序列化失败,索引只覆盖 ENQUEUED 状态。厂商称优化后达到每秒 3 万次工作流执行。
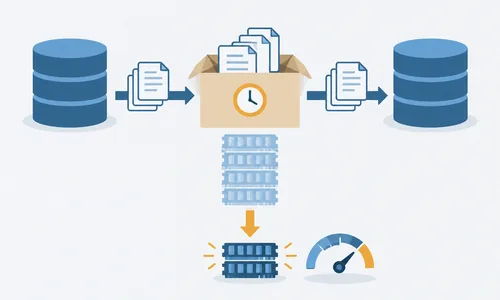
WAL-G 用 Go 写成,垃圾回收让备份与 WAL 归档的内存占用难以预测。ClickHouse 发布开源的 WAL-RUS,用 Rust 重写同一套能力,沿用 WAL-G 的配置变量,两边归档可以互读,是并行选项而非替代品。厂商测试称虚拟内存从 2.8 GB 降到 1 GB 以内,吞吐与 CPU 占用相当。ClickHouse Cloud 的托管 Postgres 将用它做默认的备份与归档机制。
Tianzhou 指出根源:PostgreSQL 用不可变的 attnum 同时表示列的身份、物理位置和显示顺序,pg_attribute 的编号顺序分配、永不复用,删列留下空洞,重排会牵动引用它的索引与约束。列顺序不只是美观,按对齐宽度排列最多省两成表体积,眼下只能用 CREATE TABLE AS SELECT 重建表。MySQL 的 InnoDB 自 8.0.29 起分开逻辑与物理顺序,社区同类提案至今未落地。
AWS 开源博客称,为 MySQL 建立开放治理是社区向前的一步,AWS、Oracle 和 Google Cloud 将共同参与新的 steering committee。The Register 的报道强调,社区想要的是具体保证而不是意向:路线图决定权、兼容性承诺和认证规则怎么落到文档上,目前都没有答案。治理变化不像版本发布那样显眼,但对兼容性和下游发行版影响更久。维护 MySQL 与 PostgreSQL 双栈的团队值得跟进。
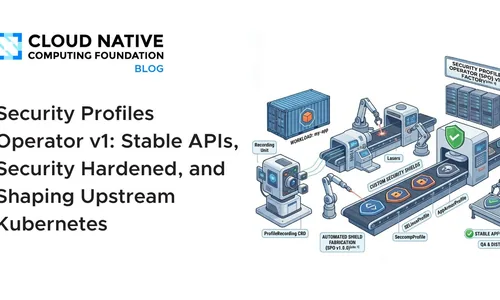
Kubernetes 的工作负载安全策略长期受制于可用性与默认配置,seccomp 与 AppArmor 的 profile 多半靠各家自己拼装。CNCF 宣布 Security Profiles Operator 发布 v1,API 进入稳定阶段,项目做了安全加固,部分设计反馈回上游。稳定的 API 意味着更多生产集群可以把安全 profile 写成可重复的配置对象,而不是一次性手工操作,也便于纳入 CI/CD 验证。
Andrey Borodin 确认 v3 补丁可干净应用于 REL_18_STABLE,新增测试在修复前失败、修复后通过。
元组相关列改用 json 保留原始表示,新增 replica_identity_full 布尔列区分全元组与基于索引的复制标识。
ChangAo Chen 的 v5 补丁拿到 LGTM;pg_repack 里同类的未加锁 aclcheck 问题另开线程处理。
The Register 称攻击瞄准开发者本机与 CI 环境里的 token,lockfile、镜像源和最小权限仍是主要防线。
第三部分聚焦 token 权限、OIDC、构建产物来源证明与审批回滚,可用来自查文档与包的发布流水线。
容器运行时漏洞往往影响宿主隔离边界,需按官方 advisory 核对版本、暴露接口与权限模型。
pgEdge 发布开源扩展 ColdFront,在 PostgreSQL 热存储与 Apache Iceberg 冷存储之间做透明分层,冷数据以 Parquet 存在 S3 上。和多数分层方案不同,归档行仍可用原有的 SQL 直接 UPDATE 和 DELETE,不用回热也不用改代码。冷数据分析由进程内 DuckDB 承担,官方称比行存快 10 到 100 倍,存储成本最多降九成,支持 PostgreSQL 16 到 18。
Highgo Software 发布 IvorySQL 5.4,内核升级到 PostgreSQL 18.4 并继承上游全部修复。新增的 IvorySQL Skills 用来把 AI 助手调教成熟悉这套数据库的专家,另有免安装的浏览器试用环境。扩展支持面扩到 pgvector、PostGIS、AGE 等二十余个,发行包覆盖 x86、ARM、MIPS 与 LoongArch,托管的 IvorySQL Cloud 5.4 同步上线。
Shaun Thomas 把 PostgreSQL 19 的分区变化称作分裂人格:ALTER TABLE 新增 SPLIT PARTITION 与 MERGE PARTITIONS,一条语句就能把季度分区拆成三个月度分区,或者把三个月度分区折回一个季度分区。两个命令适用于 RANGE 和 LIST 分区,哈希分区不行。代价是执行期间要在整张父表上加排他锁,只适合维护窗口。他判断并发版本几乎必然会在后续版本出现。
Percona 的 Jan Wieremjewicz 指出 PostgreSQL 目前没有任何关于 AI 使用的官方政策。他担心 AI 生成内容正在压垮维护者:大量低质量 PR 抬高评审成本,站不住脚的安全报告仍要人去核实,单人维护的项目最先撑不住,curl 就因此停了漏洞赏金。他主张按尊重划线:允许用 AI 起草代码、生成测试、改进文档,前提是人来复核并负责;不接受无人复核的全 AI 生成 PR,也不接受把 AI 列为共同作者。
Christophe Pettus 写了个教学库 coddpiece,用 Python 方法链写关系代数表达式,再编译成能在任何 DB-API 2.0 数据库上跑的 SQL,内置 SQLite 可直接试。每个表达式都能调 .explain() 自解释,并排给出代数记法、表达式树、编译出的 SQL 和一段白话解释。它默认按集合语义办事会自动加 DISTINCT。项目 MIT 许可,自带 C.J. Date 那套经典的供应商与零件数据集。
Andrei Lepikhov 搭了一套自动周报:让 Claude 去爬数据库方向的技术博客,核验作者是不是真的工程师,挑出新想法、生产经验和调试故事,顺手识别藏着的商业意图;它还会扫非英语来源并翻译摘要,同时跟踪 CommitFest 补丁与邮件列表讨论。成品发布在 GitHub Pages 上并提供 RSS。用了四周之后,他说信噪比比直接读 Planet PostgreSQL 好得多。
PoWA 团队发布,Tatsuro Yamada 报告的 JOIN 统计缺陷由 Julien Rouhaud 修复。
同时修正了 RHEL、Rocky 与 Alma 上的安装命令,这个扩展统计文件系统读写与 CPU。
9 月 8 日在伦敦 Cavendish Conference Centre 举行,七位讲者,早鸟票到 7 月 31 日。
Sami Imseih 让 PGSS 这类扩展可以绕开主统计哈希表,并在做带限流的 LRU 淘汰。
Robert Haas 担心 fsstate 与 active_fsstate 的连接若不一致,方案就有根本性问题。
新增 Linux 的 deb、rpm 与 Windows msi 输出,另有 desktop、fmt、LSP 与 Node 兼容改进。
CI 的成本与延迟优化下沉到步骤粒度,长流水线可以省下可观的等待时间。
供应链防线从修漏洞前移到守住维护者身份,发布权限比仓库代码更值得看紧。
工作流最难的是失败后的补偿与幂等,每一步怎么回滚应当写进接口契约。
拿到 FedRAMP 与 IL-5 之后,高监管环境的采购路径才谈得上可用。
开源项目面对的攻击方也在用 AI,防守侧需要有组织的对抗资源与流程。