大表按时间排序的查询要靠预聚合而不是索引
表长到一定规模后,按时间戳排序的查询会突然变慢:同一条语句一千万行时约 180 毫秒,五亿行时要 4 秒,因为索引超出 shared_buffers 后退化成磁盘上的外部归并排序。TigerData 的办法是别再对原始行排序,仪表盘查询改用 time_bucket() 先聚合再排序,4312 毫秒能压到 9 毫秒,高频查询用连续聚合在写入时预计算。
pgsql.cc 提供对 postgresql.org 官网内容的中文翻译,由 Pigsty 团队维护。
当天收录 37 条。
表长到一定规模后,按时间戳排序的查询会突然变慢:同一条语句一千万行时约 180 毫秒,五亿行时要 4 秒,因为索引超出 shared_buffers 后退化成磁盘上的外部归并排序。TigerData 的办法是别再对原始行排序,仪表盘查询改用 time_bucket() 先聚合再排序,4312 毫秒能压到 9 毫秒,高频查询用连续聚合在写入时预计算。
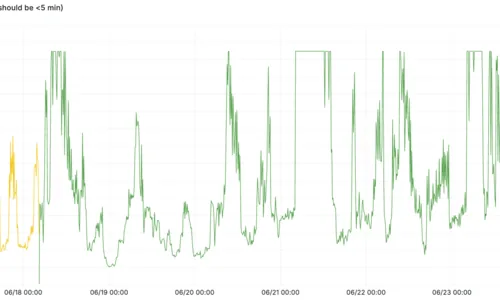
Jeremy Schneider 建议为检查点的总耗时单独设告警:在 checkpoint_timeout 保持默认 5 分钟的前提下,他倾向把阈值定在 15 分钟。更稳妥的做法是监控距离上一条检查点消息过去了多久,这样连停摆到不输出消息的情况也能发现,同时对“检查点过于频繁”告警,那通常意味着要调大 max_wal_size。他特别提醒,检查点停滞时千万不要重启数据库,重启可能让实例陷入恢复循环,把几小时的故障拖成几天。
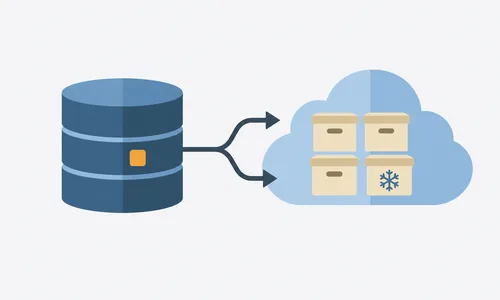
没人再查的数据和天天被查的数据占着一样贵的存储,bottomless Postgres 就是把冷数据挪到对象存储又让查询照常跨层。Shaun Thomas 回顾了几条路线:Neon 换掉整个存储引擎,pg_mooncake 把表镜像成 Iceberg,pg_lake 靠独立的 DuckDB 进程。ColdFront 则把 pg_duckdb 内嵌,归档分区后以 Iceberg 为唯一副本,用解析钩子改写 SQL 路由冷热数据。
Christophe Pettus 写了 cygnet,一个面向异步 Python 的 PostgreSQL 专用 ORM,要求 Python 3.12 与 PostgreSQL 14 以上。它的取向是透明而非省事:SQL 关键字写成大写方法,模型就是普通 dataclass,不需要继承或元类。UPDATE 和 DELETE 必须显式写 .WHERE() 才肯执行,避免全表误伤。JSONB、全文检索和 LATERAL 都是一等操作。
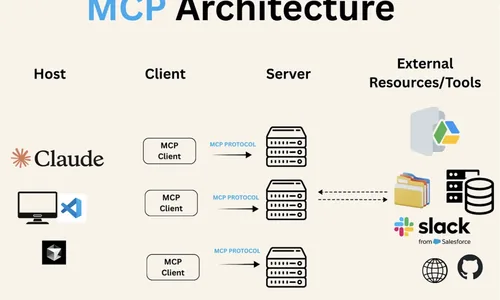
Stormatics 的 Warda Bibi 讲了怎么用 MCP 在 AI 智能体和 PostgreSQL 之间放一层受控接口,能力在代码里固定而不是靠提示词约束。文中用开源的 postgres-mcp,生产上应开受限模式,把语句包进只读事务并用 pglast 拦下 DROP TABLE。体检项包括膨胀索引、缓存命中率、空闲事务、事务 ID 年龄和复制延迟,索引建议靠 pg_stat_statements 加 hypopg 试算。
F3 是一个研究性质的列式数据文件格式,README 直说它只是验证论文想法的原型,不建议用于生产。它值得看的是设计方向:面向现代硬件和负载重构列式布局,并把解码器与数据本身绑定,让格式层能携带自描述元数据和可移植的解码逻辑。数据文件格式是湖仓、OLAP、数据交换和长期归档的底层协议,一旦这层能力变了,查询引擎、存储系统和兼容策略都要跟着调整。短期不必引入,中长期可以跟踪它的论文与基准测试。
后量子迁移不是升级一个库那么简单,它牵涉证书、TLS 终端、设备、客户端、供应商、合规,以及今天被抓走的数据在若干年后仍需保密这件事。Cloudflare 从大规模边缘网络的视角复盘了行政令给出的 2030 期限,讨论迁移步骤与目前的缺口。对基础设施团队来说,现在应该做的是盘点 TLS 终端、证书生命周期、依赖库、无法升级的老客户端,以及长期敏感数据的存放位置,而不是等到 2029 年再动手。
发布说明建议在下一个可用窗口升级,重度使用 hypertable 压缩的环境要先读变更列表。
排序、collation、TTL 和聚合累加器才是这类兼容层的关键路径,不能只测 CRUD。
Tomas Vondra 修正了 nodemask 大小与指针对齐,分区绑定与时钟扫描的收益仍不明显。
WaitEventSetWait() 的子函数退出前没清 PI_FLAG_SLEEPING,Heikki Linnakangas 已修。
Baji Shaik 的三个补丁分别挡下 epoch 之前、无穷大 interval 和超过 48 位毫秒的取值。
Tristan Partin 说动机是 UUIDv7 字典序与时间一致,取最早最新记录会方便很多。
争论点是 get_all_vacuum_rels() 里的提前权限检查该不该去掉,反正后面还会再验一次。
Peter Eisentraut 要求收窄讨论范围,先用一版补丁修掉这处空指针解引用。
自 REL_14 以来涉及 TAP 文件的提交约 172 个,两套框架并存意味着每次都要写两遍。
Agent Name Service 打算给智能体一套可信身份基础设施,把身份问题标准化。