PostgreSQL 19 支持在线开关数据校验和
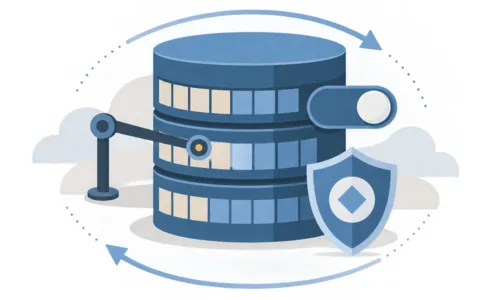
PostgreSQL 19 可以在运行中的集群上开关数据校验和,不必再停机跑 pg_checksums。新增 pg_enable_data_checksums() 与 pg_disable_data_checksums(),两者都接受 cost_delay 与 cost_limit 控制 IO 强度。后台进程逐库把缓冲区标脏重算,状态先显示 inprogress-on 或 inprogress-off,等后端吸收屏障信号后才落定。
pgsql.cc 提供对 postgresql.org 官网内容的中文翻译,由 Pigsty 团队维护。
每日精选 PostgreSQL、数据库与云计算资讯
PostgreSQL 19 可以在运行中的集群上开关数据校验和,不必再停机跑 pg_checksums。新增 pg_enable_data_checksums() 与 pg_disable_data_checksums(),两者都接受 cost_delay 与 cost_limit 控制 IO 强度。后台进程逐库把缓冲区标脏重算,状态先显示 inprogress-on 或 inprogress-off,等后端吸收屏障信号后才落定。
Lætitia Avrot 复核 Linux 7.0 改用 PREEMPT_LAZY 后 PostgreSQL 变慢的说法。Salvatore Dipietro 在 96 vCPU 的 Graviton4 上跑 pgbench,1024 客户端、100GB 共享缓冲区并关掉 huge_pages,得到 7.0 仅为 6.x 的 0.51 倍。打开透明大页后两者都回到 185k tps。结论是瓶颈在大缓冲池的 4KB 缺页,不是抢占模式。
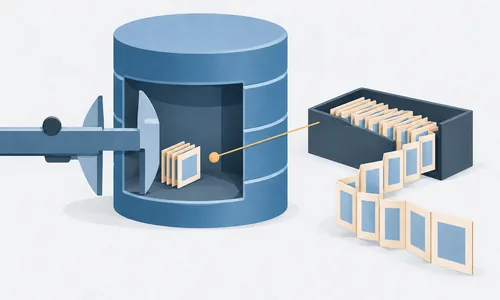
Xata 把自家的 Postgres 平台以 Apache 2.0 开源,提供秒级分支、计算自动休眠和原生 Postgres 运行。分支走写时复制:按块存储加元数据索引,克隆时只复制索引块,真正写入才复制数据,TB 级库也能在数秒内分出一份。存储与计算分离,用 NVMe over Fabrics 把存储引擎暴露到网络上。开源部分基于 CloudNativePG 与 OpenEBS,多区域部署代码和 Xatastor 存储引擎仍闭源。
pgEdge 的 Ahsan Hadi 的系列第二篇讲 RAG Server 架构与配置。Vectorizer 是一个后台工作进程扩展,靠触发器盯住源表的写入,把文本按 400 令牌切块、重叠 50 令牌,调用嵌入提供者写进 pgvector,嵌入提供者可选 Ollama、OpenAI 或 Voyage AI。RAG Server 是 Go 写的 API 服务,做向量相似度与 BM25 的混合检索,按令牌预算截断后交 LLM 生成答案。
LogTide 是面向家庭实验室和小企业的开源可观测平台,目标是在 2GB 内存里每天处理数百万条日志。创始人 Giuseppe Pollio 选了 TimescaleDB 而不是 ClickHouse 或 MongoDB,理由是兼容 PostgreSQL。厂商口径的生产数据是列式压缩把 220GB 日志压到 25GB,查询快 33% 到 41%;典型批量下写入达每秒 14200 行,过滤查询比 MongoDB 快 650 倍。
Andrew Dunstan 推送后 OpenBSD 构建农场失败,pg_basebackup 测试也暴露出疑似竞态。
补丁修掉纯归档恢复下 standby_write 等待者可能永久休眠的边角情况。
Andres Freund 主张把死锁检测放进锁管理器,Antonin Houska 担心每次插锁都要取全部 LWLock。
CloudNativePG 的 Gabriele Bartolini 把托管数据库的锁定归到一处:WAL 流不对外开放。他的说法是持续的跨区域能力依赖 WAL 流,而托管方刻意不暴露,高可用与灾备的操作逻辑被关在专有控制平面里。他给出的退出路径分三步:先用逻辑复制搭起并行环境,再做一次受控切换,停机时间取决于复制延迟而非数据量,之后靠物理复制维持长期可迁移性。
ParadeDB 是给 PostgreSQL 加全文、向量与混合搜索的扩展,现在成为 Railway 的官方集成。点一个按钮就能拉起 Docker 容器,用户名、密码和连接串等环境变量自动配好,官方口径是从零到可用实例不到一分钟。之后可以用 paradedb.create_bm25_test_table 建测试表,用 || 运算符做 BM25 检索,并用 pdb.score() 给结果排序。文章没有提到定价。
Vibhor Kumar 与 Marc Linster 出版了新书《AI-Ready PostgreSQL 18》,副标题是用事务、分析与向量构建智能数据系统,随书附开源脚本和一套电商数据集。Kumar 的判断是 AI 项目很少败在模型本身,而是败在模型周围的接缝:数据真实性、治理和生产约束,比如无法强制当前价格与库存。他主张把向量和关系事实放进同一个 PostgreSQL,用 pgvector 做语义检索,靠 SQL 约束兜住正确性。
Tiger Data 的 Matty Stratton 承认 ClickHouse 分析查询比 PostgreSQL 快 10 到 100 倍,但基准测不出维护两套库的运维成本。把数据从 PostgreSQL 搬过去要 CDC、ETL 或流式管道,随之而来的是延迟、schema 漂移和新的故障模式;ClickHouse 没有 ACID 事务,订正要即时生效时会出问题。替代方案是用 TimescaleDB 就地做列式压缩与连续聚合。
Satyanarayana Narlapuram 改用 DatumGetArrayTypePCopy 解决角色设置崩溃,Andrew Dunstan 已推送。
Amit Kapila 认为 leader 与 worker 之间的内部消息不该走 apply_dispatch(),建议单开函数。
补丁拆成 ANY 法定人数与 FIRST N 优先级两步,是否重构通用解析器仍在评估。
Nisha Moond 提议 TABLES IN SCHEMA 可排除个别表,非限定表名的归属歧义仍未定。
Chao Li 提议无主键时副本标识自动降为 FULL,社区顾虑显式配置优于隐式便利。
PostgreSQL 19 换掉了 EXPLAIN ANALYZE 的取时方式。pganalyze 的 Lukas Fittl 解释,旧的 RDTSCP 指令会阻塞并发执行,5000 万行的 COUNT(*) 开计时要 4200 毫秒、不开只要 1900 毫秒。19 改用不阻塞的 RDTSC,平均计时开销从 5–10% 降到 2–3%,并新增 timing_clock_source,x86-64 上默认走 TSC。
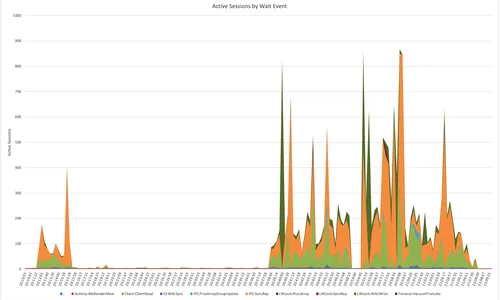
Jeremy Schneider 复盘了把 autovacuum_vacuum_cost_delay 设成 0 的后果。归零等于关掉成本控制,autovacuum 全速运行,靠提示位刷出大量脏页,WAL 量随之暴涨。现场表现是 COMMIT 上 IPC:SyncRep 等待激增,一张只做 INSERT 的 40GB 表里出现连片 FPI_FOR_HINT。改回默认的 2 毫秒后波动收敛,复制延迟和应用延迟都回落。
Richard Yen 讲解怎么用 pg_stat_activity 的 wait_event_type 与 wait_event 两列读懂后端卡在哪里,重点是保护共享缓冲区、WAL 缓冲区、锁表和 SLRU 的 LWLock。文中逐个说明 buffer_content、WALWriteLock、WALInsertLock、ProcArrayLock 的竞争场景。方法是先按等待事件分组统计,再结合并发写入和事务速率判断负载热点。
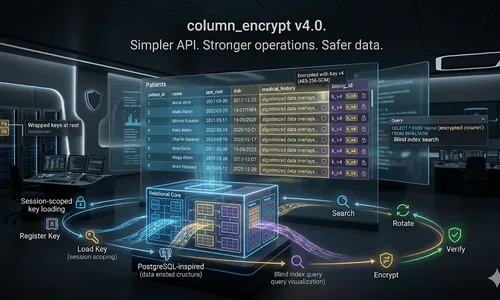
Vibhor Kumar 发布 column_encrypt v4.0,这个扩展用 encrypted_text 与 encrypted_bytea 两种类型做列级透明加密。新版把管理函数收进 encrypt schema,三角色权限模型简化为单一的 column_encrypt_user,日志脱敏改为自动完成;函数更名为 register_key、load_key、rotate 与 verify。升级需先经 v3.3 过渡。
David E. Wheeler 团队发布 pg_clickhouse 0.2.0,这是在 PostgreSQL 里查询 ClickHouse 的接口。这一版扩大了下推范围,覆盖日期、时间、数组和正则函数。PostgreSQL 用 POSIX 正则、ClickHouse 用 RE2,新代码会检查兼容性并自动补上 (?-s),关掉 ClickHouse 默认开启的 s 标志。0.2.0 完全向后兼容。
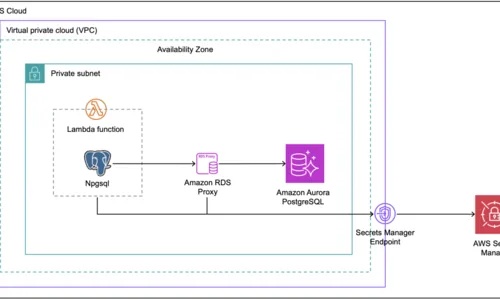
AWS 的 Ken Zhang 演示了把 .NET Lambda 接到 Amazon Aurora PostgreSQL 的做法:连接池交给 RDS Proxy,凭证放进 Secrets Manager,驱动用 Npgsql。文章附了一份 CloudFormation 模板,再给出 C# Lambda 取凭证、经代理连库查询的代码。对从 SQL Server 迁往 PostgreSQL 的团队尤其省事。
改动推送后测试覆盖成问题,Tomas Vondra 已在五台构建农场机器上手工打开 JIT。
DO ALSO 规则中的 NEW.gen 更新时返回旧行、插入时返回 NULL,存储列与虚拟列都受影响。
v16 补丁在 read_stream_begin_relation() 和 StartReadBuffersImpl() 中加校验,已确认拦住越界访问。
Andres Freund 主张把 ShareUpdateExclusiveLock 视作将升级为 AccessExclusiveLock,避免多余的会话取消。
DATASENTINEL 发布了 pg_datasentinel 首个正式版本,一个专注可观测性的开源扩展。它在 pg_stat_activity 之上补出每个后端的内存占用和实时临时文件字节数,PostgreSQL 18 及以上还给出当前执行计划 ID,并在 cgroup 环境里报告 CPU 配额与内存上限。它还跟踪 XID 消耗速率、估算距回卷上限的剩余时间,把 vacuum、检查点等事件解析成可查询的视图。要求 15 或更高版本。
Autobase 是自建高可用 PostgreSQL 集群的开源 DBaaS 替代方案。2.7.0 与 Zexa Technologies 合作,把 DBDesk Studio 作为嵌入式 SQL 编辑器接进控制台,可以直接连接集群、执行查询和管理数据;同时内置由 pg_auto_reindexer 驱动的自动索引维护,在膨胀拖慢查询之前重建。此外新增 24 个云区域,控制台镜像补上 ARM 支持。
pgEdge 的 Shaun Thomas 解释了强制检查点为何拖垮写入密集实例。定时检查点按 checkpoint_completion_target 把刷盘摊开,而 WAL 触到 max_wal_size 时的强制检查点不理会这个设置,只能立刻刷盘。测试中 1GB 配置的 TPS 从 1100 跌到 620,4GB 则保持平稳。建议写入密集场景调到 10–20GB,批量作业 50GB 以上,并打开 log_checkpoints。
Slotix 发布 DBConvert Streams 2.0,把数据迁移、数据探索和实时复制收进同一个工具。它基于 PostgreSQL 逻辑复制的 WAL 做日志式变更数据捕获,不依赖 Kafka 或额外流水线组件就能持续同步;支持与 MySQL 之间的迁移并自动转换 schema,内置 SQL 界面,还能跨 CSV、JSON、Parquet 文件做联邦查询。可本地运行,也可用 Docker 部署。
Tiger Data 的 Doug Pagnutti 用工业物联网场景说明 TimescaleDB 在哪三处突破了原生 PostgreSQL 的限制。它把表自动切成按时间划分的块,索引小到能放进内存,写入速率随之抬高;查询靠块排除只扫相关时间范围,再用连续聚合预算好汇总,把耗时从 250–1500 毫秒压到 0.4 毫秒;旧块转成列式后压缩率可达 80% 至 95%。厂商称年存储成本可能从 15 万美元降到 1.5 万美元。
Zhijie Hou 发现长事务阻止 restart_lsn 推进,WAL 被保留数小时甚至数天,补丁让工作进程定期推进。
视图里的 UNION ALL 混用 int[] 与 bigint[] 时触发 XX000,17、18 和 master 分支均受影响。
Jeff Davis 指出代码对 DatumGetArrayTypeP 的结果调用 pfree,pg_get_role_ddl() 会报无效指针。
第 27 版让 pg_test_timing 在校准频率与上报频率相差超过一成时告警,并提示改用 system 时钟源。
Andrew Dunstan 在 4 月 5 日提交了三个函数:pg_get_database_ddl()、pg_get_role_ddl() 和 pg_get_tablespace_ddl()。它们都返回 SETOF text,用变参的名值对传选项:pretty 分行排版,owner 带上属主,memberships 输出角色的 GRANT。两点限制要记住:输出里不会包含密码,函数也只重建对象本身,不含库内的表、视图等对象。
PostgreSQL 的 palloc 对单次分配有 1GB 硬上限,而 autoprewarm 转储缓存页时要一次分配整个数组,每条记录 20 字节,算下来 shared_buffers 超过约 429GB 就会越界。700GB 的机器需要约 1.75GB,于是报出 invalid memory alloc request size,后台进程随即陷入每分钟数百次的重启循环。根治要升到 PostgreSQL 16.10 以上。
pgcollection 用关联数组帮 Oracle PL/SQL 代码搬到 PostgreSQL。2.0 新增整数键的 icollection,只存显式设过的键,避开原生数组用 NULL 填补稀疏下标的问题,键是 64 位整数、值可以是任意类型。delete() 现在支持删单键、删区间和清空并保留类型。要注意 Oracle 会自动给字符串键排序,pgcollection 保持插入顺序,需要时得自己调 sort()。
高频写入下,UPDATE 和 DELETE 留下的死元组积累速度会超过 autovacuum 回收的速度,页面碎片化,性能一路下滑。Jake Hertz 指出默认设置要等 20% 的行发生变化才触发清理,对大表意味着可以攒下几百万条死元组。文章给了测量膨胀率的查询,并建议把上亿行的高写入表的 autovacuum_vacuum_scale_factor 降到 0.01 到 0.02,让清理跑得更勤。
改用 read_stream_next_buffer() 后跳过了检查,将在读流开始与 StartReadBuffers 各补一处。
十万张表约占 16MB,最终采用 will_free 指针,让调用方决定能否显式释放条目。
标志位加 CheckTableNotInUse() 的做法被指漏洞太多,也会误伤 LOCK TABLE 这类操作。
Andres Freund 建议改用带内存屏障的原子读写,并补上时间线切换等场景的测试。
新方案把发送方信息作为参数传给处理器,UID 用 0 表示未知的做法仍有争议。
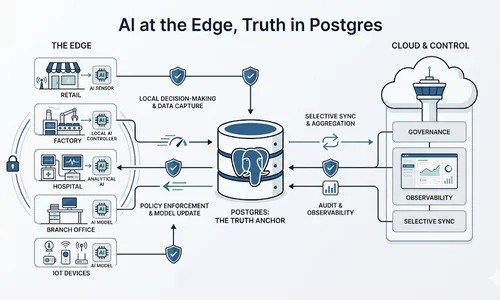
Vibhor Kumar 主张边缘 AI 的记录系统不能是概率性的:每个站点跑一个本地 PostgreSQL 作账本与策略边界,热数据留在本地,云端只做汇总、跨站分析与治理,两者之间靠 outbox 队列异步同步。落地要点包括用 INSERT ... ON CONFLICT 配稳定事件 ID 做幂等、把冲突规则写明而不是简单地后写覆盖、向量检索按租户与站点加上权限约束。他提醒 pgvector 0.8.2 的安全修复要尽快打上。
Matty Stratton 给了一个时间点:一千万行左右迁移只是一个周末的活,拖到五亿行以上就变成几名工程师做几周的项目。他把中间这段时间的查询调优、扩机器和处理故障叫作优化税,是维持原生 PostgreSQL 性能的隐性开销。TimescaleDB 的原生压缩和自动分区把这部分负担去掉。文中没有给出具体基准,判断仍应结合自己的写入速率与查询形态。
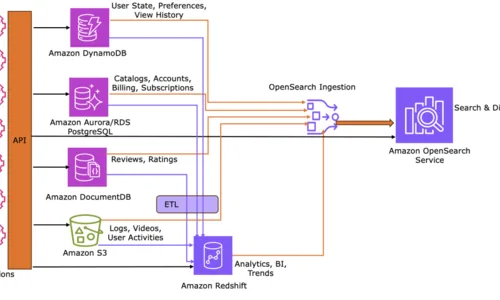
Ezat Karimi 的思路是不指望单一数据库扛下所有 JSON 场景。以视频平台为例,实时用户状态放 DynamoDB,影片目录放 DocumentDB,计费用 Aurora PostgreSQL 保证 ACID,数据湖落 S3,分析用 Redshift 的 SUPER 类型,内容发现交给 OpenSearch。各服务之间靠 OpenSearch Ingestion 做快照加持续变更捕获,在可接受的窗口内保持最终一致。
同一查询里多次调用评分函数会触发 double pfree,讨论转向为统计接口做更大改动。
回补带出 ABI 问题,新信号将挪到 ProcSignalReason 枚举末尾以免打乱既有取值。
Andres Freund 认为许多取锁路径绕开检查,应让死锁检测器真正理解锁升级。
pq_flush() 卡住导致回不到超时检查,建议改用 pq_flush_if_writable()。
审查建议只在真正记日志的路径上调用截断,回归测试也从 pg_ctl 套件挪走。
pg_column_size() 报的是一个值实际占的存储字节数,不是内容长度。Lætitia AVROT 演示了两处容易踩空的地方:一万个字符压缩后可能只占 125 字节,仍留在主元组里;而一旦被挪到 TOAST 表,主元组里永远只剩 18 字节的指针,与原始数据大小无关。她建议把 pg_column_size() 的物理均值与 length() 的逻辑均值一起算,差距大就说明 TOAST 压缩在起作用。
Laurenz Albe 对比了两边的 schema。Oracle 里用户与 schema 一一绑定,PostgreSQL 把两者当作独立概念,对象所有权也可以单独管理。命名空间的划法也不同:Oracle 按 SQL 标准分类,PostgreSQL 把所有类关系对象归在一组,迁移时容易撞名。PostgreSQL 另有 schema 级的 USAGE 与 CREATE 权限,非限定名靠 search_path 解析。
PostgreSQL 15 起,发布可以带列过滤和行过滤,不必再上中间件。Rishika Kasani 介绍的用法是:列过滤把个人健康信息、支付字段挡在源端,行过滤做多租户隔离或按地域分发。过滤在源库发送前生效,受限数据不出源系统,对 HIPAA、PCI DSS 这类合规要求有帮助。同一套 SQL 语法在 Amazon RDS、Aurora 和自建实例上通用。
把分析查询挪到只读副本,主库 CPU 和写延迟立刻缓解,但写入瓶颈一点没动。Matty Stratton 指出写路径的机制不变:每行的 MVCC 开销、每次插入和每条索引项产生的 WAL,以及和 autovacuum 抢资源。加副本反而增加了延迟监控、连接路由和多实例管理的负担,写高峰时副本一落后,读请求又回到主库。真要解决得动存储模型,例如用列式批量处理把每秒 WAL 操作从几十万降到几百。
Ahsan Hadi 演示用 pgEdge MCP Server 管一套分布式 PostgreSQL 集群:每个节点一份 YAML 配置,在 Claude Desktop 里注册成多个 MCP 条目,指向同一个二进制。三个例子分别是查 spock.subscription 看复制健康、比对两节点的列类型与索引定义找模式漂移、用 pg_stat_statements 找最慢的五条查询。服务器默认只读,写操作要显式打开。
补丁系列已全部提交,覆盖顺序扫描、位图堆扫描与 TID 范围扫描,默认关闭以免输出过长。
前三个提交已推送,用于降低 EXPLAIN ANALYZE 的计时开销,ARM 支持留到以后再做。
全局参数为零时表级 reloption 能否覆盖存在分歧,将另开线程继续讨论。
不再依赖扫描期间 NBuffers 保持不变,实测快 10% 到 30%,耗时也更稳定。
totaltime 分配移到 ExecutorStart,插件可申请仪表化级别,实测提速 4% 到 12%。
walreceiver 没给共享内存里的写入与刷新位置设初值,补丁 0001 已获认可。
Andres Freund 指出信号包装层次混乱且不便翻译,功能可能赶不上 PostgreSQL 19。