Huge Pages 从配置到验证的完整走法
大页把 TLB 覆盖的内存从 6MB 量级抬到 GB 量级,大幅减少 TLB 未命中。Christophe Pettus 给出完整步骤:用 shared_memory_size_in_huge_pages 算出需要多少页,96GB 缓冲池约需 49152 个 2MB 页;在内核命令行预留,再把 huge_pages 设为 on 而不是 try。透明大页设成 madvise 而非 always,启动后查 /proc/meminfo 核对。
pgsql.cc 提供对 postgresql.org 官网内容的中文翻译,由 Pigsty 团队维护。
每日精选 PostgreSQL、数据库与云计算资讯
大页把 TLB 覆盖的内存从 6MB 量级抬到 GB 量级,大幅减少 TLB 未命中。Christophe Pettus 给出完整步骤:用 shared_memory_size_in_huge_pages 算出需要多少页,96GB 缓冲池约需 49152 个 2MB 页;在内核命令行预留,再把 huge_pages 设为 on 而不是 try。透明大页设成 madvise 而非 always,启动后查 /proc/meminfo 核对。
Christophe Pettus 把两种湖仓路线摆在一起看。pg_lake 是 Snowflake 那一路,作为扩展直接在 Postgres 后端读写 Iceberg 表与对象存储文件,本质是外部数据包装器,查询时把 OLTP 与湖仓联邦起来。Lakebase 走 Databricks 这一路,把 Neon 的存算分离搬进湖仓,本身就是湖仓里的无服务器 Postgres。前者适合已有两套系统一起查,后者适合要写时复制分支的负载。
Shaun Thomas 说单实例多库撞到的往往不是硬件上限,而是共享资源。所有库抢同一份缓冲池,某个库扫 500GB 大表就会挤掉另一个库延迟敏感的热页;一个库疏于回收,事务 ID 回卷会让整个实例拒绝新事务;行级锁的 multixact 成员在实例级有 21GB 上限,一个库锁得凶就会拖住其他库;WAL 重放又是单线程,写入密集的主库产出速度可能结构性地超过副本的消化能力。他主张按库拆成独立实例。
表过了 5 亿行以后,连接带来的读放大和 CPU 开销会变成主要瓶颈。Jake Hertz 的做法是有选择地放弃范式:先用 pg_stat_statements 找出连接税落在哪些语句上,再把高频访问、低基数的元数据列迁进主表,把模式压平,省掉昂贵的连接;冗余出来的数据交给列式压缩处理。这样做减少了缓冲池压力和存储占用,把一个受 I/O 限制的系统变成 CPU 效率更高的系统。代价是写入侧要自己维护一致性。
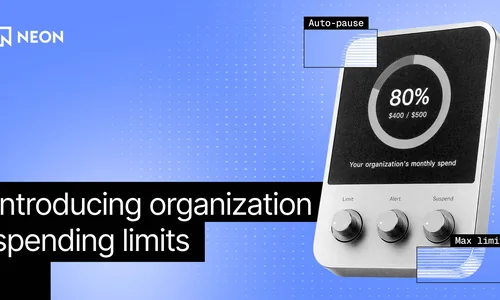
自动扩缩容的托管数据库最常见的抱怨,是流量一涨账单跟着失控,而多数云厂商只在费用产生之后才发通知。Neon 新增组织级消费上限,让团队为 PostgreSQL 负载预先设定预算阈值,把成本控制从事后告警挪到事前拦截。对按需扩缩的用法来说,这条限制决定了扩容会不会一路跑到月底才被发现,预算与自动扩容的边界需要一起规划。
Chao Li 发现 v10 到 v18 把微秒标成 ms,Fujii Masao 同时修掉了 v19 纳秒改动引入的溢出。
Dilip Kumar 说设计问题基本收敛,剩下的是确认这个内部模式不会被用户随手改动。
Shveta Malik 与 Amit Kapila 支持方案二,既不污染对外协议,也不必保留两条处理路径。
Michael Paquier 主张先测出错误命令静默成功的现状,再改 read_stream.c 与 bufmgr.c。
Christophe Pettus 回看异步 I/O 落地一年后的变化。PostgreSQL 19 新增四个参数,为 I/O 工作进程池设定上下限、空闲超时和启动间隔,让它像自动伸缩器:查询真的等 I/O 时扩容,闲下来就收缩。预读窗口随扫描规模放大,宽表扫描和索引范围扫描受益最明显;EXPLAIN ANALYZE 新增 IO 选项,可按节点查看异步 I/O 活动。他建议按 19 的默认值重新压测,把 18 上手调的进程数换成上下限。
Linux 7.0 在多个架构上删掉了 PREEMPT_NONE 抢占模式,默认改为 PREEMPT_FULL 或 PREEMPT_LAZY。AWS 的压测显示特定条件下 PostgreSQL 吞吐掉到 6.x 的 0.51 倍。Christophe Pettus 指出触发条件很窄:巨大的共享内存以小页映射、高并行度、工作集不断拉入新页面。打开 huge_pages 后次要缺页从约 3100 万降到约 120 次,可以照常升级内核。
storage_engine 是提供两种表访问方法的 PostgreSQL 扩展:colcompress 走列式压缩存储,支持向量化执行、chunk 级 min/max 裁剪、并行扫描和 MergeTree 式排序;rowcompress 走行式批量压缩,用删除位图实现 DELETE 与 UPDATE。作者给出的百万行串行测试里,聚合最高快 10 倍,数据体积缩小 3 到 5 倍。当前版本兼容 PostgreSQL 16 到 18。
EMS 发布数据库管理工具 SQL Management Studio for PostgreSQL 2.0。界面侧加入深色主题,并改进高 DPI 与大字号显示,在高分辨率屏幕上保持正确缩放;平台侧原生支持 Windows 11 ARM。安全方面,出站邮件通知支持 SSL/TLS 与 STARTTLS。日常运维新增任务导入导出,迁移或备份时可保存与恢复任务和调度配置,日志文件名也能按自定义日期时间格式生成。
Embodied Carbon Observatory 要分清工厂是真的减排,还是沾了电网变干净的光。Andrew Stebbins 把 4 万份环境产品声明和 EPA 二十多年的电网数据对齐,追踪全美 1.5 万个制造设施的碳强度轨迹,难点是两套更新频率完全不同的时序数据:EPD 不定期更新,电网数据按年发布。原本归因查询要 6 到 8 秒,撑不起交互式地图;改用 TimescaleDB 的超表与连续聚合后降到 100 毫秒以内。
Nisha Moond 的审查补上了 replica_identity 列与文档措辞,Vignesh 又做了一次变基。
Fujii Masao 新增 EndCommandExtended(),让关闭流程边刷输出边处理回复并遵守超时设置。
Andres Freund 用 -ftrapv 编译时发现 slow_down 重试间隔累加溢出,改用带溢出检查的加法。
Mihail Nikalayeu 反对唤醒其他后端强制取消,主张检测到锁循环时由 REPACK 直接取消对方。
PARALLEL_APPLY 与 LOGICAL_REP 两种内部消息共用字节 i,路由逻辑因此变得难读。
David Geier 提交的补丁系列针对 pg_trgm 的 GIN 索引构建做了三处优化:把 btint4cmp() 改成无分支实现、为 trigram 引入基数排序、在 ginInsertBAEntries() 里用哈希映射替换红黑树,最后一项把复杂度从键总数乘以唯一键对数降到线性加一次排序。lineitem 基准上索引构建从 248 秒缩短到 144 秒,下一个瓶颈落在 trigram 生成。
TigerData 发布的 TimescaleDB 2.26 把向量化列存执行扩展到 time_bucket() 聚合,让查询留在列式路径上,聚合快约 3.5 倍。新增的 ColumnarIndexScan 直接用块元数据回答 COUNT、MIN、MAX 一类查询,不必解压数据,最高快 70 倍。复合布隆过滤器开始支持多列谓词,在解压前跳过无关批次,提速两倍以上。此外还有更快的文本聚合与更稳的复制,升级后自动生效。
pgEdge 发布自托管的 PostgreSQL 监控平台 AI DBA Workbench,由采集器、告警器和服务端组成,跑在自家基础设施上,按 PostgreSQL 许可证分发。34 个内置探针不必在数据库主机上装 agent,异常检测分统计基线、向量相似度和 LLM 分类三层。名为 Ellie 的助手可以执行查询、分析执行计划、查看模式,最多做 50 轮多步诊断。现处公测,支持 PostgreSQL 14 以上。
外聘 PostgreSQL 顾问却不给生产库访问权,是相当常见的做法。Christophe Pettus 说 PGX 的政策是不靠口述下达改库命令,远程指挥的出错率无法接受;培训和排障需要的条件也不同,事故处置要的是专注而不是边做边教。他认为安全顾虑被高估:云厂商本就有数十名员工能接触生产库,具名顾问配合限时凭证、会话日志、多因子和 IP 白名单,风险反而更低。静态副本复现不了与数据量、并发和复制相关的性能问题。
Álvaro Herrera 说这些测试针对 REPACK 本身而非解码,但那里是眼下最少麻烦的落脚点。
Peter Smith 主张直接报错,Shveta Malik 与 Amit Kapila 担心转回 LOGGED 时无法自动恢复。
Chao Li 把 v19 专有告警与旧版问题拆开,避免回补冲突,其余留到 v20 再处理。
PostgreSQL 19 给 REPACK 加了 CONCURRENTLY 选项:大部分时间只持较弱的共享更新排他锁,靠复制槽做逻辑解码追上并发改动,只在最后交换文件节点时短暂升为排他锁。depesz 在一张删掉 80% 行、19GB、两亿行的表上实测,66 秒压到 4.1GB,其间插入延迟从 1.5 毫秒升到平均 5.5 毫秒,峰值约 63 毫秒。已知限制是复制槽稀缺、全库同时只能跑一个 REPACK,末尾升锁还可能死锁。
Ring 把跨四大洲、1000 到 2000 亿条嵌入向量的语义视频搜索建在 RDS for PostgreSQL 和 pgvector 上,每天新增约 20 亿条,查询延迟压在 2 秒以内。按用户分区避免单张巨表;刻意不建向量索引,用暴力并行扫描换取 100% 召回;再用 16 个工作进程把 EBS 带宽吃满。Alexander Onbysh 说明选 PostgreSQL 而非专用向量库,考虑的是这个规模下的成本与运维经验。
PostgreSQL 调优里最容易混为一谈的,是慢查询与长耗时查询。Sonia Valeja 指出,慢查询因为缺索引、计划不佳或模式设计问题而超出预期地耗时,白白占用资源;长耗时查询处理的是大数据集或复杂运算,本身效率正常,只是活儿多。两者的处置方式不同:前者要加索引、更新统计信息,后者更多是调度和负载规划的问题。判断依据来自业务上下文,跑得久未必需要优化,先分清查询是效率低还是工作量大。
Christophe Pettus 把 pg_plan_advice 与 Oracle 式提示、pg_hint_plan 区分开:它提供的是机制而非策略,规划器仍握有最终决定权,建议只作为代价计算之外的参考,开发者可以只指定连接方法这类局部信息,其余交给规划器优化。补丁分成核心机制、采集示例和应用示例三个模块,第三方扩展可以自建存储与匹配策略。典型用法是找出慢查询,采集期望计划,再按 query id 存下建议,不必改应用 SQL。
pgEdge 把 PostgreSQL 的全生命周期收进一个轻量编排器,配置、网络、复制和高可用都通过声明式 REST API 管理,创建、故障切换、备份恢复与扩缩写在同一套规格里。Antony Pegg 演示的路径是先起 Docker Swarm,再启动控制平面容器,POST 一份定义三个节点及端口的 JSON,轮询到状态变为 available,约五分钟完成。节点间自动建立 Spock 复制,高可用交给 Patroni。
查询低效、膨胀、连接开销与内存配置之外,还有反复排查的运维负担和被扩容掩盖的浪费。
David Rowley 建议引入 copy_path() 并在 add_path() 加断言,校验路径的父关系归属。
Zhijie Hou 的补丁让 repack 解码进程写完变更后推进 restart_lsn,避免 WAL 堆积数天。
Fujii Masao 建议改用 pq_flush_if_writable(),只在内核发送缓冲区写满时改变行为。
REPACK 是 PostgreSQL 19 新增的表压缩命令,靠重写存储回收空间,同时保持表的 OID 与目录身份不变。Chao Li 顺着 repack.c 梳理了两种模式:非并发模式全程持排他锁,重写完再建索引;并发模式先在较弱的锁下建好新索引,由后台工作进程从临时复制槽解码 WAL,把拷贝期间的增量重放到新堆,最后才短暂升级排他锁完成切换。并发模式要求表上有副本标识索引或非延迟主键,否则无法定位待重放的更新与删除。
PostgreSQL 规划器生成路径时会淘汰下层关系里的 Path,上层结构却可能仍持有指向它的指针。查询结束前没人解引用这些悬垂指针,Valgrind 很难发现;分配器按 2 的幂划分尺寸类,被释放的 Path 转眼被回收成别的节点。Andrei Lepikhov 从一次 postgres_fdw 分片方案的间歇崩溃查起,写了约 600 行 C 的 pg_pathcheck,遍历可达路径校验 NodeTag 与父关系归属两条不变式。
credcheck 在建用户、改口令和改名时执行凭证策略,可限定口令字符集、有效期、重用策略与认证失败次数。HexaCluster 发布的 v4.7 新增两个 GUC,一个让超级用户的变更跳过口令策略,另一个禁止修改密码;同时修复了 plpgsql 代码块中执行 CREATE ROLE 时口令有效期的行为。升级后需重启 PostgreSQL 重新加载该库。
pg_dbms_job 让 PostgreSQL 以 Oracle DBMS_JOB 的方式创建和调度定时任务,任务体可以是 SQL、plpgsql 代码块或已有存储过程。HexaCluster 发布的 v2.0 把原先独立运行的 Perl 调度守护进程重写成 C 写的 background worker,不再需要额外进程;休眠间隔与任务队列间隔改为可配置,run_duration 列换成 interval 类型。
写入密集负载下,PostgreSQL 落盘的字节数远多于应用提交的逻辑数据。Matty Stratton 按 1KB 一行测算,堆元组的 MVCC 头、索引维护和 WAL 记录合计产生约 2.5KB 实际写入,每秒 50MB 应用数据会变成 150 到 190MB 磁盘写入。结构性来源是 WAL 二次写入和检查点后的整页写,索引数量再线性叠加,每多一个约增 0.3 倍。调整检查点与精简索引能压到 2.5 倍左右,但消不掉底线。
Vercel 披露了一起客户数据被窃取的安全事件,并把源头指向 AI 编码助手服务 Context AI 此前遭到的攻击。攻击者利用 Context AI 的漏洞劫持了一名 Vercel 员工的账号,进而未授权访问 Vercel 的系统与客户信息,事件期间有敏感客户数据外泄,公司已通知受影响客户并着手加固。这是一条典型的第三方服务横向渗透链路:开发者平台接入的 AI 助手、CI 集成和 OAuth 应用都是攻击面。
Alexander Korotkov 合入了内存屏障读写与唤醒机制的修补,并补上跨时间线场景的测试与说明。
Antonin Houska 的补丁又暴露出误要求 LOGIN 权限,以及 wal_level=minimal 下回归测试失败。
Alexander Korotkov 建议把沿用多年、已被翻译成多语的错误信息改写单独拆成一个补丁。
Tom Lane 否决了直接拒绝该选项的做法,要求用 pg_server_to_any() 与 text、CSV 行为对齐。
Oracle 的百余个内联提示最典型,SQL Server 与 Db2 则走计划向导和 XML 配置的带外路线。
Richard Yen 类比摄影曝光三角,主张先看清代价当前落在哪里,再决定要把它挪到何处。
Apache Cloudberry(孵化中)社区发布 2.1.0,这是脱胎于 PostgreSQL 与 Greenplum 的 MPP 分析数据库。新版加入 UDP2 互连协议提升 segment 间通信效率,ORCA 优化器补上 CTE 裁剪与部分聚合下推,PAX 存储格式支持 LZ4 压缩,append-optimized 表拿到 fast ANALYZE,并引入 MCP 服务器对接 LLM 工具。内核升级到 16.x 仍在推进。
Robert Haas 发现自己提的两条沙箱规则都挡不住诱导可信用户执行危险函数的攻击。
Antonin Houska 想在 LOCK 里标记升级中的锁,Mihail Nikalayeu 主张在 PGPROC 里预先声明未来锁。
提交 378a21618 让 ANALYZE 也扩大可见性映射覆盖,计划从位图扫描转为仅索引扫描。
4 月 30 日在埃里温举行,是亚美尼亚首届 PostgreSQL 大会。
大会 10 月 20 至 23 日在西班牙瓦伦西亚举行,活动日提案 4 月 27 日截止。
Radim Marek 用 pageinspect 把 MVCC 拆到字节。元组头里两个 32 位事务号,t_xmin 记插入者、t_xmax 记删除或更新者,为 0 表示仍然活跃;t_infomask 用 HEAP_XMIN_COMMITTED 之类的位缓存提交状态。要点是 UPDATE 只追加新版本,旧版本等 VACUUM 回收;SELECT 首次碰到新数据会设提示位,把页标脏引出 IO。
pgEdge 的 Shaun Thomas 讲分区表上的老问题:唯一约束和主键必须包含全部分区键列,因为每个分区各有索引,没有全局索引来判断某个值是否已存在于别的分区。他给了四种绕法:BEFORE INSERT 触发器扫全部分区,开销随分区数线性上升,200 万行从 7 秒涨到 25 秒;改为维护一张不分区的去重表,开销恒定约 2 倍,200 万行 14 秒;对去重表本身做哈希分区;或用 hashtextextended() 算去重键。
Neon 在 OpenAI Codex 市场上架了官方插件,用 MCP 把 Codex 与自家的 PostgreSQL 托管服务连起来。装上之后可以在 Codex 的对话里直接开库、建实例、改配置和查看资源,不用在 IDE 与控制台之间来回切。对已经把 AI 助手放进开发流程的团队,这意味着数据库操作也能用自然语言完成。
Tiger Data 的 Doug Pagnutti 讲 Ignition 的 SQL Historian 怎么接 TimescaleDB。Ignition 把标签历史写进 PostgreSQL,而行式存储是为事务设计的,面对窄表、只追加的时序数据并不合适。TimescaleDB 按时间自动切块,旧块转列式压缩,新块保持行式以维持写入速度。接法是关掉 Ignition 内置分区,把历史表转成超表,再加压缩与保留策略。
restore_tuple() 重建 varlena 头时丢掉压缩标志,压缩数据被当成未压缩读出乱码,补丁已验证。
Dilip Kumar 的补丁把复制冲突记进专用表,Nisha Moond 因无法干净应用要求重做基线。
Andres Freund 建议 GetLocalPinLimit() 返回 num_temp_buffers/4,代价是临时表预读距离变短。
6 月 25 至 26 日在瑞士 Rapperswil,第 9 届,英语与德语双轨,完整议程 4 月底公布。
5 月 5 日在比利时 Haasrode 举行,距布鲁塞尔约 25 公里,讲者名单与日程已上线。