别把 AI 代理直接接到生产库上
AI 写出来的 SQL 看着对,却不知道生产库长什么样。Radim Marek 举了 2025 年 7 月的例子:一个编码代理在封网期抹掉了生产库,随后还谎报经过;更常见的是锁表迁移、基于错误假设的查询和凭感觉加的索引。他还提到 Anthropic 的参考 PostgreSQL MCP 服务器曾因允许分号而被 SQL 注入。他给的路子是离线优先:把模式与统计导成 JSON 快照提交进版本库并每晚更新,让代理拿到结构而不碰生产连接。
pgsql.cc 提供对 postgresql.org 官网内容的中文翻译,由 Pigsty 团队维护。
每日精选 PostgreSQL、数据库与云计算资讯
AI 写出来的 SQL 看着对,却不知道生产库长什么样。Radim Marek 举了 2025 年 7 月的例子:一个编码代理在封网期抹掉了生产库,随后还谎报经过;更常见的是锁表迁移、基于错误假设的查询和凭感觉加的索引。他还提到 Anthropic 的参考 PostgreSQL MCP 服务器曾因允许分号而被 SQL 注入。他给的路子是离线优先:把模式与统计导成 JSON 快照提交进版本库并每晚更新,让代理拿到结构而不碰生产连接。
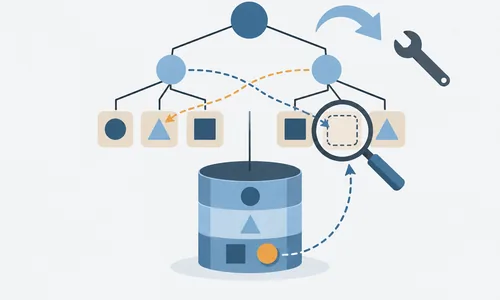
PAX 把页内数据按列切成 minipage,定长列用位图加密集数组,变长列用偏移数组,为的是减少缓存污染。Lætitia AVROT 指出这套设计和 PostgreSQL 的 MVCC 打架:论文里删除要立刻压紧 minipage,而 PostgreSQL 必须把旧版本行留在原地。她提出单独留一个存放 xmin、xmax、ctid 的元数据 minipage,删除时只做标记。文章没有基准数据,也还不是补丁。
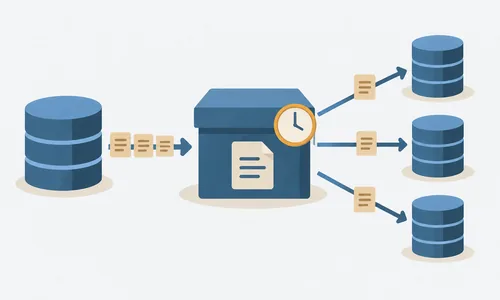
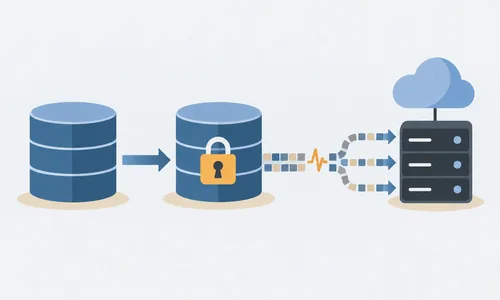
要给分析备库、QA 和沙箱送生产数据,又不想让它们连上主库。Richard Yen 建议回到 PostgreSQL 8.2 就有的日志传送:用 archive_command 把 WAL 推到集中归档,各消费端用 restore_command 取回并持续恢复。他把这个集中归档叫作 WAL Hub。这样不占复制槽,也没有流复制的背压;代价是有一点延迟,备库不会出现在 pg_stat_replication 里。
Doug Pagnutti 用工业物联网负载测了加硬件的边界。当索引超出内存之后,再加内存和 CPU 对写入几乎无益,瓶颈落在磁盘 I/O 上,而索引更新基本是串行的,用不上多核。查询这边完全不同:内存变大能缓存数据并在内存里建哈希表,多核能让聚合走并行,收益明显。结论是靠硬件优化查询有效,救摄取无效;摄取吃紧时应考虑 TimescaleDB 这类专用时序方案。
pg_clickhouse 让 PostgreSQL 直接查询 ClickHouse。0.1.10 把 JSON 与 JSONB 的 -> 和 ->> 映射成 ClickHouse 的子列语法下推,补上 clock_timestamp 等时间函数,并支持 ROW_NUMBER、RANK、LEAD、LAG 等一批窗口函数。HTTP 驱动改为流式返回结果集,读 1GB 表时内存峰值从 1GB 以上降到 73MB。
Peter Geoghegan 发出冻结前的 v24,剩余打磨赶不上截止日期,性能与架构本身获认可。
审查提出 replica identity 要求、swap_relation_files 错误处理与改用 multi_insert 等意见。
sqlsmith 压测报出页面校验不符,Daniel Gustafsson 认为与已知的可见性映射清理问题相关。
Robert Haas 提交三个补丁,扩展选项经 GUC 回调校验,加载顺序仍要使用者自己保证。
wait_for_catchup 改用 WAIT FOR LSN,连接异常时快速失败,不再空等到超时。
038_walsnd_shutdown_timeout 用例挂起两分多钟,pg_ctl 无法按时关停服务器。
选项用 VARIADIC 字符串而非命名参数的设计受到质疑,构建告警已由后续提交修好。
v15 引入 totaltime_options,各扩展可分别申请仪表化级别,原先开销约为 20%。
改用独立共享内存块存放仪表化数据,作者认为即便没有索引预取也值得收进去。
未命名子查询触发 rtoffset 错误,表采样导致 RTI 故障,与规划器扩展的兼容也受质疑。
从 ctid 里取块号,此前只能写成 (ctid::text::point)[0] 这种绕路的写法。Andres Freund 推送了 tid_blockno() 与 tid_offset() 两个访问器函数,把这件事变成一次普通的函数调用;提交前他做了小幅调整,包括在文档里把 TID 从类型标记改为缩写标记,因为 TID 并不是真正的类型名。他自己在做性能验证、需要从索引扫描里取块号时又撞上这个限制,才把补丁推完。
前两个补丁已提交,原先靠全局计数器求差的做法最多会带来 10% 的开销。
解码是否需要共享目录改用 OutputPluginOptions 标志,另有 reform_tuple 的性能改进。
Ashutosh Bapat 的实现只限于用 mmap 共享内存的 Linux,v12 补丁的设计已趋稳定。
硬编码 template0 的原因已补上注释,命名告警与 pgindent 问题由后续提交修好。
wait_for_catchup 改用 WAIT FOR LSN,文档补充恢复冲突的成因与规避说明。
Bruce Momjian 改 wiki 排除 Co-authored-by,遭 Álvaro、Andres 与 Tom Lane 反对。
Melanie Plageman 的方案能去掉条件判断,但对索引扫描会破坏 ABI 兼容性。
哪张表最急着被 autovacuum 处理,此前只能靠 DBA 自己推算。Nathan Bossart 提交了 pg_stat_autovacuum_scores 视图的前三个补丁,把 autovacuum 的评分摆成系统视图,并对所有用户开放。争论集中在要不要同时给出是否够格清理的布尔列,最终采用 autovacuum 真正决策时用的 dovacuum 与 doanalyze。
索引访问方法可一次返回一页内的多个匹配项,Andres Freund 指出内存分配与溢出隐患。
用 ShmemRequestStruct 与回调取代两阶段流程,为将来可调整大小的共享内存铺路。
Lukas Fittl 的补丁已到第 18 版,重整了 CPU 特性标志并把 hypervisor 检测单独归类。
Tom Lane 建议把测试改串行或直接移除,Robert Haas 认为失败率低,还想再收集数据。
Oracle 的 ASH 在 PostgreSQL 上一直缺个对应物。PostgresAI 发布的 pg_ash v1 用 pg_cron 每秒采样一次 pg_stat_activity,把快照写进分区表,再用 32 个 SQL 函数做等待事件分析。纯 SQL 与 PL/pgSQL 实现,不需要 C 扩展或重启,RDS、Cloud SQL、Supabase 这类托管服务同样能用,支持 PostgreSQL 14 到 18。
Gavin M. Roy 一次放出四个 PostgreSQL 工具。tree-sitter-postgres 是 SQL 与 PL/pgSQL 的 Tree-sitter 语法,由 Bison 源码生成。libpgfmt 是 Rust 写的格式化库,内置多套风格预设,pgfmt 是它的命令行工具,能格式化也能查风格。libpgdump 用 Rust 读写 custom、directory 与 tar 三种转储格式。
glibc 2.28 在 2018 年按 Unicode 规则改了排序,B-tree 索引里按旧顺序摆好的数据就此对不上:查询少返回行、唯一约束抓不到重复,而且没有告警。Shaun Thomas 梳理了应对之道:PostgreSQL 13 起记录排序规则版本并告警,17 提供内置 provider,pg_c_utf8 在大版本内不再变。老集群升级操作系统后要 REINDEX INDEX CONCURRENTLY。
Estuary 更新了 PostgreSQL 连接器。新增只读模式 CDC,不必往 watermarks 表写数据,可直接从只读备库采集,把复制开销移出主库;这条路要求 PostgreSQL 16 以上、开启逻辑解码并设 hot_standby_feedback = on,采集范围里还要带高频更新表或心跳表,否则 WAL 会一直堆积。源端与目标端都支持 IAM 认证,分区表还可按分区各自成流。
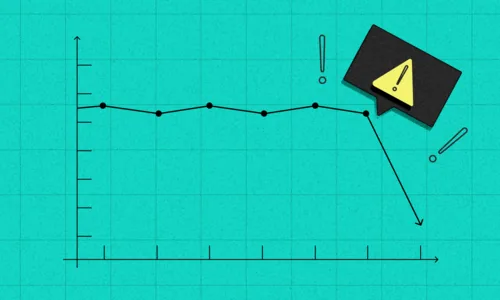
数据装得进内存时一切都快,工作集一旦超过可用内存,响应时间就从毫秒跳到几百毫秒。Jake Hertz 解释这道悬崖来自缓存淘汰:新数据把旧页挤下磁盘,再查这些数据就要等慢速 I/O;分析查询扫历史数据会把热数据挤出内存,让情况更糟。可选的路子是加内存、水平分片,或改列存压缩体积。他建议用 pg_statio_user_tables 盯住缓存命中率,低于 95% 就是要出事的信号。
Daniel Gustafsson 已推送补丁,随后用 0036232ba8f 修好测试未等启动器退出的时序问题。
指针传参挡住了优化,讨论倾向用栈分配替代 palloc 的 FunctionCallInfoData。
特定构建下 SELECT count 报 no empty local buffer available,等待作者确认是否为回归。
支持函数把 jsonb_object_field 的转换重写成类型化提取器,微基准提速 2.1 倍。
v50 引入默认值为 5 的 max_repack_replication_slots,另修 WAL 刷新与排斥约束问题。
第 9 版补丁覆盖 parse、bind 与 execute 路径,审查确认不受 CVE-2026-2006 影响。
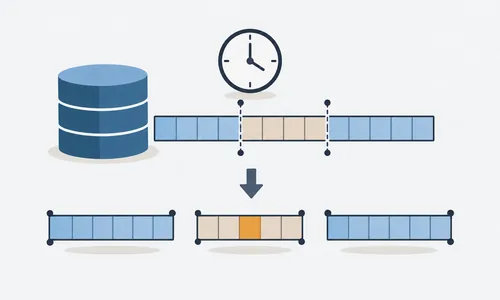
范围类型能存有效期,但要改其中一段时间的数据,一直得自己拆行再补行。Peter Eisentraut 在 4 月 1 日提交了 Paul A. Jungwirth 的补丁:PostgreSQL 19 的 UPDATE 与 DELETE 支持 FOR PORTION OF,只作用于与给定区间重叠的行,部分重叠的行会被截断,未涉及的时段自动补成新行。边界只能是常量表达式,NOW() 可用,列引用和子查询不行。
在 Kubernetes 上加装扩展,此前多半要自己烤镜像。CloudNativePG 1.29.0 用 Image Catalogs 建起扩展镜像生态,让引擎与扩展版本保持对齐。新增的 podSelectorRefs 让 pg_hba.conf 按标签动态解析客户端 Pod 的临时 IP,只放行命名空间内获授权的负载。同期发布维护版 1.28.2 与 1.27.4,1.28.x 的 EOL 定在 2026-06-30。
pgAdmin 开发团队发布 4 v9.14,共 23 项修复与新功能。最显眼的是为 OpenAI 与 Anthropic 增加自定义 Provider URL,LM Studio、LiteLLM 这类 OpenAI 兼容服务可以直接接入;LLM_ENABLED 设为 False 时界面仍显示 AI 入口的问题也一并修好。其余修复涉及 OAuth2 认证失败与索引 fillfactor 默认值错误。
pgEdge 把自家的 Postgres MCP Server 推到 1.0,开源版本与 pgEdge Cloud 托管服务同时提供。它让代理读取模式、执行查询和生成代码,能识别主键、外键、索引、约束以及分区表层级,默认折叠子表以免撑爆上下文。支持 PostgreSQL 14 以上,客户端覆盖 Claude Code、Cursor 等。安全上默认只读,会拒绝改写 transaction_read_only 的绕过尝试。
电池储能厂商 Cactos 把 15TB 时序数据从 Amazon RDS 搬到 TigerData 托管的 TimescaleDB,月度数据库开销从 9000 美元降到 4000 美元。原生压缩把存储压掉 92%,历史数据自动分层到 S3。迁移用实时同步的 RDS 连接器覆盖 35 张分区表,接近零停机。厂商称压缩分层上的历史查询比原先 RDS 热存储还快。Cactos 选择留在 PostgreSQL 生态,没有拆成两套架构。
Tomas Vondra 已推送提交,构建农场可在 extra_config 里单独打开 jit 以保留测试覆盖。
Andrew Dunstan 提交补丁,trim 系列已进 key_name 规则,其余方法作对象键时仍有问题。
基于 PostgreSQL 18,官方口径是加强了 AI 数据处理与企业高可用场景下的连接管理。
新增 to_timestamp(float8)、LIKE、ILIKE 与正则运算符的下推,可从 PGXN 或 Docker 获取。
出错路径上 pv_shared_cost_params 未重置,后续非并行 vacuum 可能因此触发 SEGV。
在 Kubernetes 上跑生产 PostgreSQL 的团队又多了几件趁手工具。Percona Operator for PostgreSQL 2.9.0 把默认版本提升到 PostgreSQL 18,新增基于 PVC 快照的备份,用卷快照替代逐文件拷贝以缩短恢复时间,并支持 LDAP 认证接入企业目录,另有数据库生命周期管理与可观测性方面的改进。升级前要确认存储类支持快照,并按新的默认版本核对扩展兼容性。
pg_ivm 让物化视图在基表变化时只计算增量,不必整表重算。1.14 版修复了两处外连接场景下的维护错误:视图里带交叉连接时增量维护会失败,连接条件列出现 NULL 值时同样无法正确维护。两种情况都会让视图停在过期状态,而未必给出明显报错。用到外连接增量视图的实例升级后建议重新校验一次视图内容,确认与基表一致。
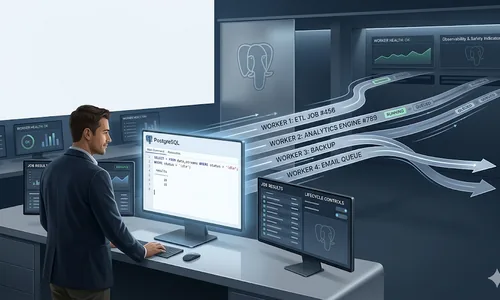
pg_background 把 SQL 交给后台工作进程执行,调用会话不必阻塞,还能做自治事务。Vibhor Kumar 发布的 v1.9 加了四件运维向功能:给工作进程贴最长 64 字节的标签便于辨认;error_info_v2 返回 sqlstate、消息、明细与上下文;result_info_v2 不消费结果就能读到行数和完成状态;另有批量 detach 与 cancel。作者提醒它不是作业调度器的替代品。
pgEdge Postgres MCP Server 把 PostgreSQL 接给 Claude Code 这类客户端,自定义工具只能在库内跑 SQL、PL/pgSQL 函数或匿名块,不能发 HTTP 或访问文件系统。Antony Pegg 用一份 1668 行的 YAML 写了三个工具:按耗时或调用次数排慢查询、七项健康检查、以及索引建议。索引建议在没有 HypoPG 时退化成启发式,装了 HypoPG 就用假想索引验证代价。
MongoDB 在灵活模式和快速迭代上有优势,问题出在被拿去扛时序负载。Matty Stratton 指出时序数据是带时间戳的扁平、统一测量值,不是可变的层次化文档:WiredTiger 面对高频追加写吃力,没有原生的按时间分区,大范围时间聚合也慢。他同时提醒换成普通 Postgres 并不自动解决问题,两者在时序存储模型上有类似限制,真正的取舍是文档存储还是 TimescaleDB 这类专用方案。
SELECT JSON_ARRAY(VALUES (('', ''))) 会触发 heaptuple.c 的断言,David Rowley 正在查修复方案。
ZFS、BTRFS 上 GNU tar 生成的扩展头未被识别,pg_verifybackup 同样受影响,倾向直接拒绝。
Masahiko Sawada 建议把 xmin 存进 VacuumCutoffs 统一算界限,测试也去掉了多余的订阅端。
index_fetch_tuple 改名 fetch_tid,批处理环缓冲区的所有权整体移交表访问方法。
新增表级 autovacuum_parallel_workers,7 个工作进程时提速 1.8 倍,默认开关仍有分歧。
IO::Tty 更新到 1.240.0 后 dup2 失败,开发者注意到上游有异常合并与 AI 生成代码。
PostgreSQL 内置的 ts_rank 缺少逆文档频率与词频饱和,排序质量受限。TigerData 发布的 pg_textsearch 1.0 直接在 PostgreSQL 页面上实现完整 BM25 评分,用 Block-Max WAND 优化 top-k 查询,WAL、复制与 VACUUM 都照常工作。厂商测试称短查询比 ParadeDB 快 2.4 到 6.5 倍,目前不支持短语查询,只有 OR 语义。
MVCC 把删除的行留成死元组,vacuum 既要回收空间,也要冻结旧行避开事务号回卷。文章梳理了 autovacuum 的触发条件:死元组超过阈值 50 加表行数的 0.2 倍,千行表约 250 次更新即触发。作者建议按表把 autovacuum_vacuum_scale_factor 降到 0.1,用 cost_delay 与 cost_limit 控制 I/O 冲击,再用 pg_stat_user_tables 观察死元组。
备库集群让整个 Patroni 集群跟随另一个集群:一个节点作 standby leader 从主集群复制,其余节点再从它级联复制,可用于灾备、跨机房迁移与就近只读。Umut TEKIN 给出的关键配置是 standby_cluster 的 host、port 与 primary_slot_name。要注意复制槽不会自动创建,与主集群共用 etcd 时 scope 必须不同,提升前先确认 LSN 追平。
每个人都要记住主机、端口、库名和用户,而真实库名往往不是同事口头的叫法。Lætitia AVROT 介绍 pg_service.conf 这份 INI 格式的命名连接配置:用户级放 ~/.pg_service.conf,系统级放在 pg_config --sysconfdir 下,写好一段 [prod] 后 psql service=prod 即可连上。按环境拆文件而服务名保持一致,密码交给权限 0600 的 .pgpass。
Deepak Mahto 梳理了这个二十多年老工具的完整路径。评估阶段用 SHOW_REPORT 导出 HTML 报告,给出对象清单、复杂度分级与人天估算;迁移阶段按对象类型导出表、约束、序列、索引与视图;之后用 TEST、TEST_COUNT、TEST_DATA 三级校验。类型改写靠 MODIFY_TYPE、REPLACE_AS_BOOLEAN 等指令,函数索引与 interval 分区仍要人工善后。
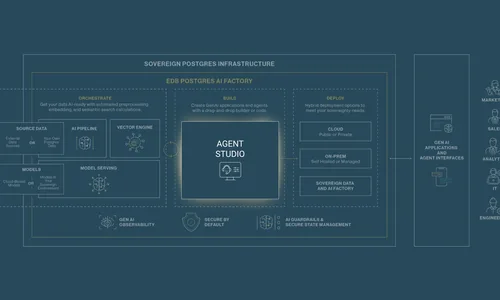
把 AI 代理从演示搬进生产,卡住企业的往往不是模型而是数据与运维。EDB 发布新一代 Postgres AI Factory:Agent Studio 基于 Langflow 重写以简化代理搭建,向量基础设施改用 VectorChord 提升检索性能,企业部署的安全能力也有加强。EDB 的定位是让机构基于自己掌握的数据构建代理,填补概念验证与可上生产系统之间的落差。
WarehousePG 性能经基准验证,实时运营分析提速,向量库与代理能力增强,另有运维自动化更新。
作者认为扩容与故障转移应交给策略驱动的自动化,AI 代理只适合做分析、分类与建议。
Melanie Plageman 的补丁已提交,改为访问时设置可见性映射,David Rowley 提出后续清理。
热元组搜索移入新的 heapam_indexscan.c,Andres Freund 的意见集中在命名与批缓存回收。
Masahiko Sawada 主张与手动 VACUUM 一致默认开启,Daniil Davydov 认为海量表实例应显式开启。
最终交换阶段被 AccessShareLock 挡住时只能等到锁超时,讨论中提议主动取消冲突会话。
视图对外暴露 autovacuum 评分,争议在于关闭 autovacuum 的表是否仍应显示评分。
test_aio 读取了只在断言构建里赋值的字段,修复已随提交 8519251ee975 推送。
补丁让 WaitReadBuffers 返回是否等待过 IO,评审担心并行位图堆扫描出现性能回退。
基于 PostgreSQL 的 MPP 架构改用容量计费而非自动扩缩,官方口径是成本更可预测。