边缘 AI 把 PostgreSQL 当作事实来源
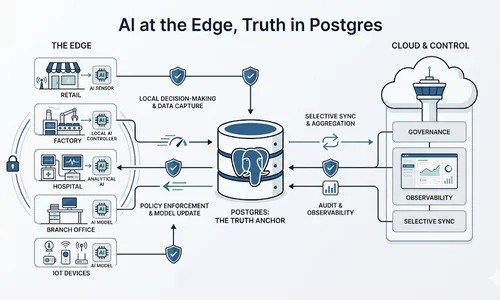
Vibhor Kumar 主张边缘 AI 的记录系统不能是概率性的:每个站点跑一个本地 PostgreSQL 作账本与策略边界,热数据留在本地,云端只做汇总、跨站分析与治理,两者之间靠 outbox 队列异步同步。落地要点包括用 INSERT ... ON CONFLICT 配稳定事件 ID 做幂等、把冲突规则写明而不是简单地后写覆盖、向量检索按租户与站点加上权限约束。他提醒 pgvector 0.8.2 的安全修复要尽快打上。
pgsql.cc 提供对 postgresql.org 官网内容的中文翻译,由 Pigsty 团队维护。
当天收录 12 条。
Vibhor Kumar 主张边缘 AI 的记录系统不能是概率性的:每个站点跑一个本地 PostgreSQL 作账本与策略边界,热数据留在本地,云端只做汇总、跨站分析与治理,两者之间靠 outbox 队列异步同步。落地要点包括用 INSERT ... ON CONFLICT 配稳定事件 ID 做幂等、把冲突规则写明而不是简单地后写覆盖、向量检索按租户与站点加上权限约束。他提醒 pgvector 0.8.2 的安全修复要尽快打上。
Matty Stratton 给了一个时间点:一千万行左右迁移只是一个周末的活,拖到五亿行以上就变成几名工程师做几周的项目。他把中间这段时间的查询调优、扩机器和处理故障叫作优化税,是维持原生 PostgreSQL 性能的隐性开销。TimescaleDB 的原生压缩和自动分区把这部分负担去掉。文中没有给出具体基准,判断仍应结合自己的写入速率与查询形态。
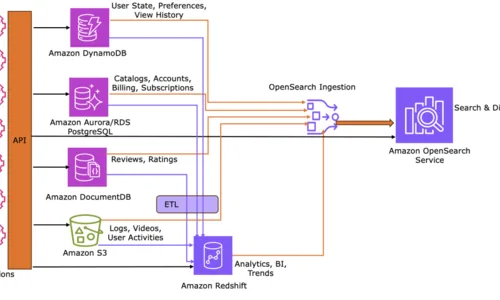
Ezat Karimi 的思路是不指望单一数据库扛下所有 JSON 场景。以视频平台为例,实时用户状态放 DynamoDB,影片目录放 DocumentDB,计费用 Aurora PostgreSQL 保证 ACID,数据湖落 S3,分析用 Redshift 的 SUPER 类型,内容发现交给 OpenSearch。各服务之间靠 OpenSearch Ingestion 做快照加持续变更捕获,在可接受的窗口内保持最终一致。
同一查询里多次调用评分函数会触发 double pfree,讨论转向为统计接口做更大改动。
回补带出 ABI 问题,新信号将挪到 ProcSignalReason 枚举末尾以免打乱既有取值。
Andres Freund 认为许多取锁路径绕开检查,应让死锁检测器真正理解锁升级。
pq_flush() 卡住导致回不到超时检查,建议改用 pq_flush_if_writable()。
审查建议只在真正记日志的路径上调用截断,回归测试也从 pg_ctl 套件挪走。