一组 PgBouncer 进程把连接池吞吐提到 4 倍
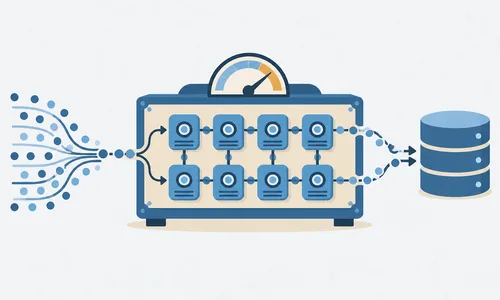
PgBouncer 是单进程单线程的,机器再大也只吃得下一个 CPU 核。Kaushik Iska 给出实测:16 vCPU 机器上单个进程约 8.7 万 TPS 到顶,单核占用 97%,整机利用率不到 10%。他们改成按核数起一组 PgBouncer 进程,用 so_reuseport 让内核做负载均衡,再在进程间做 peering 处理跨实例的查询取消。256 个并发客户端下这组进程跑到约 33.6 万 TPS,用满 8 个核。
pgsql.cc 提供对 postgresql.org 官网内容的中文翻译,由 Pigsty 团队维护。
当天收录 34 条。
PgBouncer 是单进程单线程的,机器再大也只吃得下一个 CPU 核。Kaushik Iska 给出实测:16 vCPU 机器上单个进程约 8.7 万 TPS 到顶,单核占用 97%,整机利用率不到 10%。他们改成按核数起一组 PgBouncer 进程,用 so_reuseport 让内核做负载均衡,再在进程间做 peering 处理跨实例的查询取消。256 个并发客户端下这组进程跑到约 33.6 万 TPS,用满 8 个核。
Neon 推出 Lakebase Search,由 lakebase_vector 与 lakebase_text 两个扩展提供向量和全文的混合检索。向量侧用 IVF 分区加 RaBitQ 量化,把向量压缩约 32 倍,索引可直接放在数据湖上,同时兼容 pgvector。文本侧不再依赖 GIN,改用原生 BM25 索引保存全库统计量,支持真正的相关性打分和 top-K 下推。两个索引面向对象存储而非常驻内存,现已开放。
pglayers 把 PostgreSQL 扩展做成预编译的 Docker 层:每个扩展发布成一个 FROM scratch 的镜像,在官方 postgres 镜像上用 COPY --from 一行叠一个。PostgreSQL 18 以上采用隔离布局,每个扩展放进各自的子目录,靠 extension_control_path 参数避免文件冲突。项目按 MIT 授权,目前支持 80 多个扩展,17 与 18 稳定,19 还是实验性的。
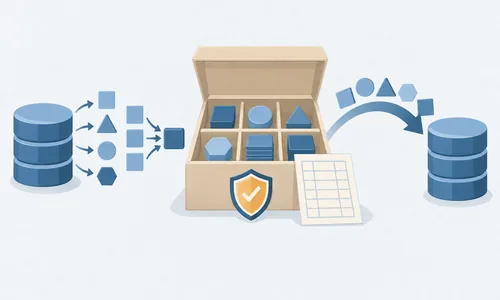
Cybertec 的 Hans-Jürgen Schönig 沿着一次备份的生命周期讲 pg_hardstorage:数据怎么被抓取、怎么进入仓库、怎么组织,最后又怎么在恢复时被拼回来。文章展开的是内容寻址存储、分块与去重、清单结构、元数据管理、完整性校验、损坏处理和垃圾回收这些机制,而不是操作手册。作者想说的是,备份跑成功只算一半,知道数据在系统里怎么流动同样重要。
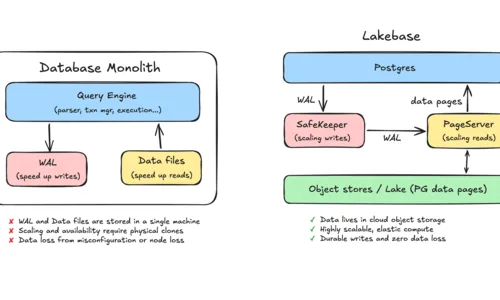
Databricks 的 Reynold Xin 提出 LTAP:在存储层而不是引擎层统一两类负载,让它们读同一份数据。Lakebase 把预写日志交给 SafeKeeper、数据文件交给 PageServer,从单体 PostgreSQL 里拆成独立的云服务,计算层因此无状态。PageServer 把页面落到对象存储时顺便转成列式 Parquet,并保留类型系统与多版本语义。厂商称写吞吐提高 5 倍、读延迟降低一半。
ClickHouse 26.6 的发布说明里列出了 hypothetical skip indexes、可级联刷新的物化视图,以及仍处于实验阶段的 continuous queries。方向是把分析数据库往自助优化、增量刷新和流式分析上推。对采用 PostgreSQL 加 OLAP 组合架构的团队来说,值得看的是物化视图刷新和连续查询能不能替掉一部分外部流处理组件。
Cloudflare 开放 Monetization Gateway 的等待列表,允许对放在 Cloudflare 后面的网页、数据集、API 或 MCP 工具收费,用 x402 协议结算。AI 智能体会大量读取网页、API、数据集和工具,传统的广告与订阅模型未必适配机器流量,把计费放到边缘层会改变内容和 API 的商业模式讨论。如果自家文档、API 或工具将来要面向智能体访问,机器流量的授权、限流和计费策略得提前想清楚。
CNCF 的文章介绍 Kubernetes 的动态资源分配 DRA,称它已在 Kubernetes v1.35 达到 GA,NVIDIA 的 GPU DRA 驱动也进了 Kubernetes SIGs。AI 负载让设备调度变得复杂,DRA 之后 GPU 不再只是一个可数的资源,而可以有更细粒度的声明和分配方式。运行 GPU 或 AI 集群的团队值得跟一下 DRA、驱动和调度器生态的进展,别被旧的 device plugin 模型限住。
Álvaro Herrera 反对新增 DDL 语法,Andrey Borodin 建议改成 pg_drop_invalid_indexes() 函数。
MariaDB 允许但结果可能不一致,DB2 在定义阶段就禁止;作者给出运行时检查和只补测试两案。
选定待删槽位到锁定数据库之间的窗口里,用户新建的槽可能复用同一槽位而被误删。
用 CloudWatch Database Insights 建一个中心监控账号,把跨环境的看板与告警路由统一起来。
同批更新还有 ECS 部署熔断设置、Service Connect 区域感知路由和 CloudWatch 日志查询告警。