数据校验和的 TAP 测试暴露崩溃恢复竞态
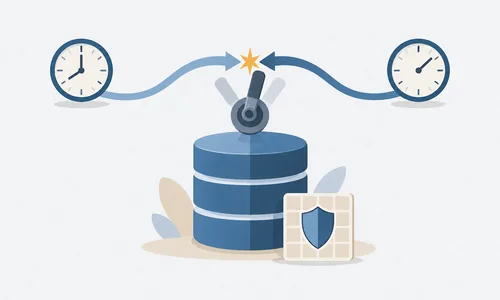
Tomas Vondra 给刚进主干的在线切换数据校验和写了一套 TAP 测试,用大约 80 个注入点检查状态变更与 checkpointer 之间的竞态。状态分散在四处,各由不同的锁保护。测试发现崩溃恢复后的最终状态会在 on 和 off 之间摇摆,取决于启动器写 XLOG2_CHECKSUMS 记录与 checkpointer 读共享内存做 REDO 的先后。他质疑 DELAY_CHKPT_START 是否真能挡住这类竞态。
pgsql.cc 提供对 postgresql.org 官网内容的中文翻译,由 Pigsty 团队维护。
每日精选 PostgreSQL、数据库与云计算资讯
Tomas Vondra 给刚进主干的在线切换数据校验和写了一套 TAP 测试,用大约 80 个注入点检查状态变更与 checkpointer 之间的竞态。状态分散在四处,各由不同的锁保护。测试发现崩溃恢复后的最终状态会在 on 和 off 之间摇摆,取决于启动器写 XLOG2_CHECKSUMS 记录与 checkpointer 读共享内存做 REDO 的先后。他质疑 DELAY_CHKPT_START 是否真能挡住这类竞态。
REPACK 的并发执行仍有正确性问题。Mihail Nikalayeu 报告说即使打上针对 SNAPBUILD_CONSISTENT 的最新修复,压力测试照样失败:唯一索引创建时报重复键,pgbench 侧出现除零错误。008 号并发测试被那个修复治好了,007 号仍稳定复现;把 need_shared_catalogs 置为 true 能绕过,说明当前方案有根本缺陷。Antonin Houska 承认要查旧问题。
Grigory Smolkin 提交第 5 版补丁,处理流复制与 WAL 归档之间的交互,问题出在管着数千个集群的生产环境里。v5 的主要改动是只传时间线 ID 和段号而不是完整 WAL 文件名,把一部分工作挪到归档进程,并为 walreceiver 与归档进程加共享内存协调。四个设计问题待定:备库要不要更新 pg_stat_archiver、两类 ready 文件怎么处理、切换点计算能否简化、强制归档是否全收进归档进程。
逻辑复制的冲突日志历史表卡在权限上:非超级用户的订阅所有者访问不了 pg_conflict 模式里的冲突日志表,原因是查询分析阶段过早做了 ACL 检查。Dilip Kumar 试过绕开模式检查和干脆取消限制,都不合适;Shveta Malik 提议单给订阅所有者授 USAGE,但订阅所有者本身没有授权的权限。最后 Amit Kapila 提议把该模式的使用权授给 pg_create_subscription 角色,表级操作仍限本人。
Christophe Pettus 回顾故障转移复制槽的两年。PostgreSQL 17 引入三件套:订阅的 failover 选项、备库的 sync_replication_slots、主库的 synchronized_standby_slots;18 只修缺陷;19 增加动态 wal_level 与 slotsync_skip_reason 列。它保证提升后新主库的槽位不会跑到订阅者前面。但槽位复制是异步的,提升前必须手动核对位置。
Richard Yen 讲清了拿 Postgres 做任务队列会撞上什么。高并发下大量工作进程用 SELECT FOR UPDATE SKIP LOCKED,多个事务会短暂引用同一行,产生的 MultiXact ID 堆进固定大小的 SLRU 缓冲区,后端排队在 LWLock:MultiXactSLRU 上,吞吐随之塌陷。任务行反复更新删除,死元组产生得比 autovacuum 回收快,几兆有效数据的队列表能涨到几十 GB。
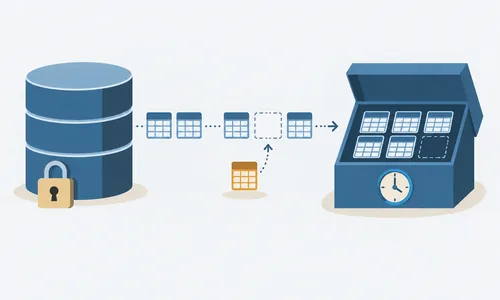
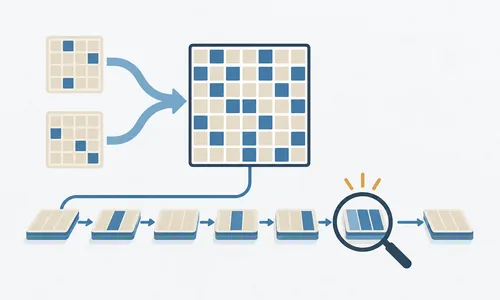
Christophe Pettus 拆解了 PgQue 的做法:消费时完全不改事件表。事件写进轮转的表,事务 ID 作列默认值;一个 ticker 每秒抓一次 pg_snapshot,相邻两个快照之间就是一个批次,消费端据此判断可见性;三张表靠 TRUNCATE 轮转,不做垃圾回收。算法出自 Marko Kreen 2007 年前后的设计。代价是事件要等下一个 tick 才可见,端到端一到两秒。
Vibhor Kumar 借 pgBackRest 被原作者 David Steele 归档一事,把开源许可证和运营可持续性分开来谈。项目做了十三年,用的是 MIT 许可证,法律和结构上完全开放,谁都可以分支,但归档意味着它已无人维护。他的看法是一个项目可以在法律上开放、在运营上脆弱。给企业的建议是别只查许可证合规,还要问治理:有没有共享的维护权、透明的决策和可持续的资金。
Tom Lane 指出 load_hosts() 的返回类型声明不一致,并嫌函数名太泛,Daniel Gustafsson 认可修法。
Peter Eisentraut 要求改局部变量名并补锁,担心并发 DROP LABEL,同时反对顺手加 OidIsValid。
Nathan Bossart 要删已被移除的实现引用,Tom Lane 同意清死代码但主张保留 HAS_TEST_AND_SET。
Daniil Davydov 同意先作为 0003 提交,评审定案后再并回 0001 和 0002,以免 cfbot 报错。
行模式识别的补丁推进到 v47。Tatsuo Ishii 追问 JIT 编译除已支持的 PREV 和 NEXT 之外,是否也覆盖 FIRST、LAST 及其复合形式;Henson Choi 确认 v47 里这些导航操作都已支持 JIT,实现只用两个操作码,各操作之间的差异放在执行层处理而不进 JIT 层。随后 Tatsuo 发布 v47 补丁,带来导航操作的单槽模型、完整 JIT 编译和 tuplestore 修剪优化。
PgQue 发布 0.1,用纯 SQL 与 PL/pgSQL 把 Skype 当年的 PgQ 架构搬到现代 Postgres 上,托管平台不提供 PgQ 扩展也能用。它不走 SKIP LOCKED 配合删改的热点路径,而是用基于快照的批处理加表轮转,避开库内队列在高负载下的死元组、VACUUM 压力和索引膨胀。安装只需一个 SQL 文件,支持 PostgreSQL 14 到 18,自带重试与死信队列。
面向 PostgreSQL 的 Prometheus exporter pgexporter 发布 0.8.0。这一版引入新的 Vault 安全机制,已有部署需要迁移;指标大量补充,其中包含 PostgreSQL 18 的相关指标;仪表盘改用 Grafana 12;新增初始的告警子系统与 Web 控制台。同批发布的 pgagroal 2.1.0 与 pgmoneta 0.21.0 也换了同一套 Vault 机制。
备份恢复工具 pgmoneta 发布 0.21.0,带来新的 Vault 安全机制(需要迁移)、S3 存储引擎改进、pgmoneta-walinfo 交互模式改进和一份西班牙语手册,另有大量增强与缺陷修复。它面向 PostgreSQL 14 及以上,支持全量与增量备份、恢复、gzip 与 zstd 等四种压缩、AES 加密、符号链接、WAL 归档传输以及热备。pgBackRest 停止维护之后,它是仍在活跃维护的开源备份方案之一。
Tiger Data 的 Matty Stratton 整理了一份扩展速查表,逐条给出用 PostgreSQL 顶替七类专用数据库的 SQL 写法:pg_textsearch 做全文检索替 Elasticsearch,pgvector 做向量检索替 Pinecone,TimescaleDB 管时序替 InfluxDB,UNLOGGED 表做缓存替 Redis,pgmq 做队列替 Kafka,JSONB 存文档替 MongoDB。
旧行为下 walsender 关闭时用阻塞刷写,可能挂到 TCP 重传失败,修复因改了函数签名不回迁。
Alexander Korotkov 把补丁拆成 0001 加测试记录现状、0002 实现修复,并放行临时表的 LOCK TABLE。
PostgreSQL 19 的发布说明列了 212 项改动,Christophe Pettus 认为多数运维只需盯住其中四项:由工作进程自动管理、参数可调的异步 I/O;针对 LEFT JOIN 形态改进的查询规划;pgstattuple 借流式读取明显提速;以及扩展从此必须按 C11 而非 C99 编译。他把这一版定性为面向管理与监控的版本,改进多是渐进的运维体验,没有面向用户的招牌特性。扩展维护者要留意编译标准的变化。
Melanie Plageman 提交补丁修复可见性映射的 WAL 记录缺陷:清除 VM 位时没有把 VM 缓冲区注册进 WAL 记录,而 WAL 摘要器只统计已注册的页面,增量备份便会漏掉这些改动,产出损坏的备份。修法是清位时注册缓冲区,并在关键区间持有排他锁。Andres Freund 指出 heap_update 可能以任意顺序获取多个 VM 页锁而死锁,建议按块号升序加锁。
Dilip Kumar 正按评审意见推进逻辑复制的冲突日志历史表,让冲突记录进表而不只是打进日志。当前争议在 ConflictLogDest 的表示上:log、table、all 三个目标用位图还是普通枚举,Peter Smith 主张位图以便直接做位运算,另一派认为普通枚举更好扩展。此外还有订阅所有权变更时的归属处理,以及非超级用户访问 pg_conflict 对象的权限问题待定。
Henson Choi 在 v46 基础上放出 40 个增量补丁推进行模式识别。0001 到 0031 保持不变以保留既有评审状态,新增的 0032 到 0040 回应 Tatsuo Ishii 的意见:修正绕过 A1 帧优化的测试、改写注释与报错语态、用 Max() 和 Min() 宏替换手写极值代码、把设计说明挪进 README.rpr、跑 pgindent 并统一 pg_proc.dat 描述。另有三件事推后处理。
pgBackRest 原作者 David Steele 收手之后,PostgreSQL Experts 接手做了一个延续性分支 pgxbackup,并应 Steele 的要求不再沿用原名。分支保留并行备份恢复、时间点恢复、页级校验和、加密、多仓库与归档管理等能力。PGX 承诺的范围是关键缺陷修复、跟进新 PostgreSQL 版本的兼容性,以及保证已有备份仓库仍能正确恢复,不引入破坏性改动。代码沿用原许可证并接受外部贡献。
pgEdge 发布开源的 AI DBA Workbench,定位是给 PostgreSQL 团队一个随叫随到、仍由人复核的运维副驾驶。它持续采集查询性能、VACUUM 活动、连接健康、WAL 吞吐和复制延迟等指标,异常检测分三层:统计基线、基于向量相似度的模式匹配,再加 AI 分类。团队可以先不开 AI 功能,只当传统可观测性工具用,准备好了再打开。pgEdge 给出的背景是 DBA 难招、成本高,强监管行业还要走数月的安全审查。
Doug Pagnutti 讲了在一家炸药制造厂用 HiveMQ 企业版 MQTT 代理解决产线数据的经历:需要把 SCADA 的实时数据送到外部机器学习服务器做参数优化。他的评价是传输可靠、配置简单,需求变化时加主题也容易。其内置的 PostgreSQL 连接器与 TimescaleDB 搭配处理时序负载,因为后者本身就是 PostgreSQL 扩展,接入只需配好连接器并对齐表结构,查询不用改。
一个黑客组织宣称对 Ubuntu 与 Canonical 站点的分布式拒绝服务攻击负责,攻击导致多项服务中断,用户一度无法更新系统。受影响的是分发侧的关键设施,管理员依赖的安全补丁与软件维护渠道随之受阻,波及范围覆盖全球。事件把开源软件分发渠道在协同攻击面前的脆弱性摆上台面:镜像和更新服务一旦不可用,下游的补丁节奏就会被打乱。用 Ubuntu 源部署数据库的团队值得回头检查本地镜像与离线包的兜底。
SATYANARAYANA NARLAPURAM 发现它对 unlogged 关系也发 WAL,补丁改用 RelationNeedsWAL() 保护。
Fujii Masao 确认补丁已进主干,Chao Li 此前在 macOS 上跑通了 make check-world。
Michael Paquier 反对回迁,Daniil Davydov 认为这就是缺陷,Jim Jones 追问下一步怎么走。
根因是 Windows 上的 SSPI 认证没给 regress_seq_repl 配好,补上 auth_extra 后由 Amit Kapila 推送。
数据校验和过去只在 initdb 时决定,事后要改就得停下实例跑 pg_checksums 或者重建。Daniel Gustafsson 在收到 Ayush Tiwari 的评审意见后,提交了在运行中的集群里启用或禁用数据校验和的补丁集,落地前又做了一轮编辑性修改。这意味着管理员不必完全停机或重建数据目录,就能给已有集群打开校验和,对排查静默数据损坏是一项实打实的运维改进。补丁进的是主干,现有版本仍需沿用离线流程。
Masahiko Sawada 确认 procsignal barrier 存在竞态:一个进程发出屏障信号时,另一个进程正处在槽位代号与 pid 初始化之间,等待函数便无限期等下去,表现为启动阶段死锁。Alexander Lakhin 用插入睡眠的补丁复现了这一场景。问题从 v15 一直存在到 master,只是早前版本用到屏障的地方少、命中概率低,去年 12 月扩大屏障用途的提交让报告多了起来。建议把修复回迁到 v15。
逻辑复制自动同步 DDL 的路线又吵了一轮,焦点是两条:现有的 JSON deparsing 把解析节点转成 JSON,再在订阅端还原;另一条从系统表变更反向重构语句。Amit Kapila 主张沿用前者,因为过滤和模式映射更灵活。Masahiko Sawada 担心维护成本,也不满它对输出插件不够中立。Andres Freund 指出反向重构会丢掉 ALTER COLUMN 的 USING 子句这类语义信息。事件触发器管理仍无定论。
连接池 pgagroal 发布 2.1.0,补齐监控与高可用。新增查看 Prometheus 指标的 Web 控制台;故障切换后可执行脚本,用来通知其余备库;新增健康检查工作进程定期查询主备,pgagroal-cli ping 随之显示各服务器健康状态;启动时校验备库与主库版本是否一致。配置侧新增 pgagroal-config 命令,可交互生成配置,也可脚本化修改。测试套件亦重构并扩大覆盖。
pgBackRest 停止维护,Christophe Pettus 给出一份替代品对照。他先说明没有能直接顶替的工具:其价值在并行备份恢复、块级增量、delta restore、异步 WAL 归档和多存储后端这一整组能力上。替代路径有四条:有独立备份主机的机房用 Barman,跑 S3 兼容存储的用 WAL-G,单个小集群可用 pg_basebackup 加脚本,云上则用 barman-cloud。他强调不必着急,先并行验证再迁移。
Christophe Pettus 实测 Tiger Data 的 pgvectorscale,并给出不靠 Elasticsearch 的混合检索写法。其核心是 StreamingDiskANN 索引:完整向量留在 SSD 上,内存只放压缩向量用于遍历估距,配合每维一到两位的统计二值量化,绕开 HNSW 必须常驻内存的限制;标签过滤在遍历中生效。他在 100 万条 1536 维向量上测得 p95 延迟约为 HNSW 的九分之一。
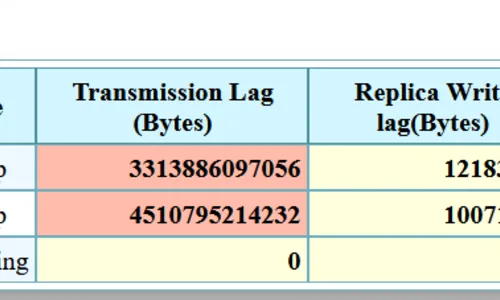
Percona 的 Jobin Augustine 把逻辑复制延迟的排查整理成一套依赖等待事件和统计信息的流程。文章拿积压 4.5TB 的真实案例做示范,说明 WalSenderWriteData 等待事件如何指向两端之间的网络问题。他把延迟归为三类:订阅端应用得慢、网络饱和、大事务突发。判断方法是把两端等待事件形态、LSN 差值和日志对照着看,据此区分瓶颈在发送端、订阅端还是链路本身。
EDB 称平台面向常驻运行的 AI 智能体,官方引用的预测是 2028 年企业 AI 数据库支出增长两倍。
作者主张在应用层用正则加 LLM 预分类识别易变问题,让它们绕开缓存直接问模型。
Zhijie Hou 说明了 HTAB、dshash、simplehash 三种哈希表的分工,并调整命名与补丁顺序。
Fujii Masao 直接在 WalSndDone() 里加循环,避免 CommandComplete 之后追加 COPY 消息违反协议。
Corey Huinker 给了两版改法:pg_mbcliplen 配 memcpy 防多字节截断,或干脆去掉字符串缓冲区。
Dilip Kumar 的补丁让 CREATE 和 ALTER PUBLICATION 的报错显示完全限定名,同名表不再有歧义。
Jim Jones 把补丁同步到最新主干,这轮只是常规维护更新,没有新的评审反馈。
PostgreSQL 19 内置的 REPACK 把 VACUUM FULL、CLUSTER 和外部扩展 pg_repack 的活儿收拢到一条命令。Christophe Pettus 说 pg_repack 不会明天过时,但已在倒计时。加 CONCURRENTLY 后靠逻辑解码免去全程排他锁,他测得重建期间插入平均 5.5 毫秒、峰值 63 毫秒。未了的还有并发执行要占复制槽、压缩 TOAST 仍有损坏场景,他建议等 Beta 1。
PostgreSQL 18 的 io_workers 是个静态池,默认 3、上限 32,启动时定好就跟不上负载变化。19 把这一个旋钮换成四个可动态调整的参数,池子按队列深度伸缩,空闲进程会退休。io_method 仍是三选一:sync 传统路径、worker 各平台通用、io_uring 在 Linux 上更快但可用性有限。Christophe Pettus 提醒这套只覆盖读取,WAL 与共享缓冲区的写入仍是同步的。
Alexandra Wang 提交了连接统计的正式补丁,接续她一月的概念验证,并吸收了多位审阅者的意见。这一版改用基于索引的连接采样,目录结构复用现有 MCV 字段并新增三个可空列,支持完整的 JOIN 语法;能力范围仍限于等值连接、两表连接和 MCV 统计。在 Join Order Benchmark 上,基数估计的几何平均 q-error 从 103.4 倍降到 4.2 倍,执行时间热启动快 1.54 倍、冷启动快 1.37 倍。
Matty Stratton 把数据库性能问题分成两类:优化问题改一次就长期有效,架构问题改完还会随数据增长再冒出来。配置不当、缺索引、写法低效属于前者;行存要读进用不上的列、写入型数据的 MVCC 开销、不断上涨的维护成本属于后者,大容量高写入叠加分析查询时尤其明显。判别方法是看修复的有效期:每次见效的时间越来越短,说明撞的是架构约束。他给出的解法是 TimescaleDB 的行列混合存储、自动时间分区与连续聚合。
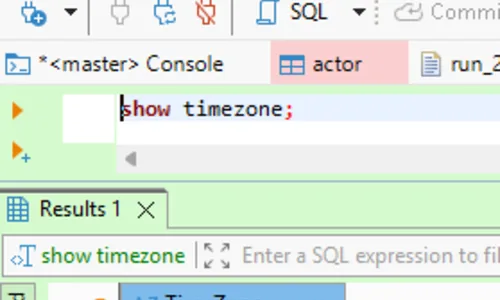
DBeaver 背后是 PostgreSQL JDBC 驱动,连接时不会自动跟随服务端时区,默认按客户机本地时区解释和显示。服务端跑 UTC 而客户端在别的时区时,timestamptz 的显示就会和服务端对不上,跨地域复制环境尤其容易踩到。Dave Stokes 给了两条改法:在偏好设置的界面时区里选 UTC 后重启,或在连接的驱动属性里加上 serverTimezone 设为 UTC。
Daniel Gustafsson 在恢复结束时刷新控制文件里的校验和版本,并简化退出处理器的安装时机。
Andres Freund 指出带 USING 的 ALTER COLUMN 无法只靠目录重建,转换表达式并不写进 WAL。
位标志便于检查 ALL 下的多个目标,普通枚举更省内存,取舍看未来的取值是否互斥。
David Steele 在 4 月 27 日宣布 pgBackRest 不再维护,仓库转入归档。项目长期依赖单一维护者加 Crunchy Data 的赞助,这套结构在赞助方易主后没能撑住。Jan Wieremjewicz 指出软件本身仍能用,真正的风险是方向不明和各自拉分支造成碎片化。Percona 表态继续把它作为自家发行版推荐的备份方案,同时提出三条长期出路:基金会托管、多厂商共同治理,或并入 PostgreSQL 生态。
pgBackRest 的结局让 Gabriele Bartolini 把话讲明白:维护关键基础设施需要全职投入,也就需要收入,开源不是免费的,总得有人付钱。他回顾 pgBackRest 与 Barman 用不同架构解决同一问题,认为这种竞争让两边都变好了。他提出的良性循环是:企业出钱养工程师,软件在生产中创造价值,用户购买商业支持,收入再投回工程。CloudNativePG 进入 CNCF Sandbox 则带来了厂商中立的治理。
PostgreSQL 19 新增并行 autovacuum,用一个全局上限参数和一个按表参数控制,默认关闭。Christophe Pettus 提醒并行只作用于索引清理,堆扫描和截断仍是单线程,只有多索引的表才吃得到收益;而 VACUUM 压倒性地受 I/O 限制,存储已经打满时加进程只是排更长的队。这些进程还与查询并行共用 max_parallel_workers 池,可能抢走普通查询的槽位。他建议整体保持关闭,只对重索引表按表打开。
更新一行就要改所有索引,是 PostgreSQL 写放大的主要来源,HOT 更新是它的逃生口。Radim Marek 梳理触发条件:新元组要放得进同一页面,且被修改的列都没有索引,缺一不可。写多的表可以把 fillfactor 从默认的 100 降到 80 到 90,给 HOT 链留空间,代价是多占存储。效果看 pg_stat_user_tables 里 HOT 更新数与总更新数的比值,比例下滑就该查。长事务会阻止页面裁剪。
Christophe Pettus 开了个托管 Postgres 评测系列,第一篇给 Amazon RDS。长处是它十多年来一直能用,与 AWS 生态整合广,蓝绿部署让大版本升级不再吓人。短处集中在自主权:扩展版本滞后,plpython3u 一类根本没有;没有真正的超级用户;存储只能加不能减;单备机的 Multi-AZ 走块复制,备机不可读。他的结论是已在 AWS、负载中等、没有专职 DBA 的团队最合适。
Daniel Gustafsson 移除在线检查点里的校验和更新,并把控制文件更新排到信号屏障之前。
Masahiko Sawada 为 PG20 重启这项工作,新增 DDLCommand 类型,直接写 WAL 供所有插件使用。
取值 log、table 或 all,选表时在 pg_conflict 模式下按订阅 ID 自动建表,命名仍在争论。
Ayush Tiwari 的补丁修掉提前返回时未清理的关系指针,并补上能复现崩溃的 TAP 测试。
Alexander Korotkov 认可 Xuneng Zhou 的改写,并为新函数补注释,建议推送整个补丁集。
David Steele 独自维护 pgBackRest 十三年,在原赞助方兼雇主 Crunchy Data 被出售后另寻工作未果,宣布停止维护。Lætitia Avrot 指出,成百上千家机构在生产中用着它,出事时却只剩一个活跃赞助方,行业把钱投向 GPU 和模型,没人愿意养一个专职做数据完整性与灾难恢复的人。她给出的替代是 Barman:pg_basebackup 没有备份目录和 WAL 保留管理,pg_dump 谈不上时间点恢复。
PostgreSQL 19 支持不停机开关数据校验和,命令立刻返回,集群照常服务,后台进程在后面逐页重写堆和索引。Christophe Pettus 提醒这才是真正的工作量:每个关系的页面都要读进缓冲区、算校验和、再经 WAL 写回,大集群要几个小时,I/O 压力接近 VACUUM FULL,会与 autovacuum、正常负载和备份抢资源,造成复制延迟,云上还可能耗尽突发 IOPS。中途打断会让集群停在混合状态,安全但不该长期挂着。
PostgreSQL 19 引入第一个零售式 DDL 函数 pg_get_database_ddl(),可直接重建 CREATE DATABASE 与 ALTER DATABASE 语句,并能选择是否美化输出、是否带上属主和表空间。以往要取单个对象的定义,只能 shell 出去跑 pg_dump -s 再 grep。Christophe Pettus 说它面向管理查询与模式比对工具,不是备份替代,后续还会覆盖表和索引。
pgclone 是一个用 SQL 命令跨实例克隆数据库、schema 和表的 PostgreSQL 扩展,走 COPY 协议加自定义后台工作进程,在库内完成克隆,不依赖 pg_dump、pg_restore 或外部脚本。4.0.0 内置脱敏函数,可在克隆时匿名化邮箱、姓名、电话等字段,还会自动扫描源 schema 标出疑似敏感列。索引、约束、触发器、视图和序列都会保留,目标端已有对象可选报错、跳过、替换或改名。
Kajabi 要在近乎零停机的前提下升级一套 39TB 的 Aurora PostgreSQL 12,同时切到 Aurora I/O-Optimized 计费。常规升级路径撑不住动态负载,团队改用蓝绿部署叠加原生逻辑复制,用 6 到 8 个复制槽分摊高流量表的压力,并分两段走:先升到 13 以启用 I/O 优化存储,再升到 15。切换由 PgBouncer 接管流量,控制在 10 分钟以内,官方口径的成本降幅是 80.53%。
Bitmap Heap Scan 分两步:先用一个或多个索引建出匹配行的位图,再按物理顺序访问堆页,把随机 I/O 换成顺序 I/O。规划器一般在选择度居中时选它,也就是行数多于索引扫描划算的范围、又不值得全表顺序扫描。它还能用 BitmapAnd 和 BitmapOr 组合多个独立索引,省掉专门的复合索引。内存不够时位图退化成只记页面级信息,堆访问阶段要靠 Recheck Cond 补做过滤。
Haibo Yan 的五个补丁用类型转换钩子识别 cast(extract(...)),直接改写成带类型的提取函数。
Nisha Moond 发现表名已存在会触发 Assert 崩溃,非超级用户订阅所有者也读不到自己的表。
Hayato Kuroda 采纳方案二,把消息类型改名为 PAWorkerMsgType 并修正依赖跟踪逻辑。
Andres Freund 担心缓存失效回调仍会间接访问,Amit Kapila 认为该实现尚未取得共识。