PostgreSQL 博览
每日精选 PostgreSQL、数据库与云计算资讯
2026-05-27 Christophe Pettus thebuild.com
PostgreSQL 19 的 REPACK CONCURRENTLY 重写表回收空间,不必长时间持有排他锁。实现出自 Álvaro Herrera,源头是 Antonin Houska 的 pg_squeeze。它不用触发器记录复制期间的改动,而是复用 CREATE SUBSCRIPTION 初始化表的机制:在与 VACUUM 同级的锁下取快照并建逻辑复制槽,解码增量回放到新副本,最后短暂升级为排他锁完成切换。每个集群同时只能跑一个。
2026-05-27 Peter Geoghegan pgsql-hackers
Peter Geoghegan 在停顿一段时间后重新推进索引预取。v25 相比 v24 没有实质改动,主要是跟上 master 并满足 commitfest 测试要求。这组补丁里他优先处理第一个:让索引扫描改用更高层的、基于 slot 的接口来调用表访问方法。他认为这一部分比后续补丁简单得多,计划在四到八周内提交。这项工作原本针对更早的版本,现已重新定位到 PostgreSQL 20。
2026-05-27 Andrew Stebbins TigerData 博客
建筑智能平台 ApexAnalytica 从原生 PostgreSQL 迁到 TimescaleDB:此前扫描数百万条半小时计量读数的仪表盘查询要六秒以上,改用超表加 time_bucket 物化视图后,同样的 12 个月小时级热力图查询降到一秒以内。平台从 38 栋建筑摄取楼宇自控遥测,速率在每秒一千到一万个数据点之间,事务数据和用于检索增强生成的 pgvector 向量都放在同一个实例里,省掉了另建时序数据库的基础设施。
2026-05-27 Slava Sarzhan Percona 博客
Slava Sarzhan 补上从 Crunchy Data 算子迁到 Percona PostgreSQL Operator v3.0.0 的另外两种做法。备份恢复法先从源集群做一次 pgBackRest 备份,再用它引导新的 Percona 集群,需要一小段停机但速度最快;持久卷复用法直接把现有主节点的数据目录挂给新集群,省掉拷贝但存储资源要处理得更小心。两种方法都在 PostgreSQL 18 上验证过。
2026-05-27 Elizabeth Garrett Christensen Snowflake 工程博客
Apache AGE 给 PostgreSQL 加上 openCypher 支持,让关系数据和图遍历在同一个库里完成,不必另起一套图数据库。文中的做法是从 Iceberg 表出发,用 PL/pgSQL 循环执行 Cypher 命令建出节点和边,只把节点与边的属性复制到本地,其余列留在对象存储。查询可以把 Cypher 包进 CTE 再与 Iceberg 表连接,示例用变长路径匹配找转诊链路,比递归 CTE 简洁得多。
2026-05-26 Nathan Bossart pgsql-hackers
Nathan Bossart 提议废弃 PQfn()。这个函数 2003 年就被标为过时,2026 年又标为不安全,除 libpq 内部的大对象接口外没发现第三方直接使用。方案是让它无条件返回错误但保留符号。Debian 代码搜索显示多个语言绑定仍引用它,维护者同意废弃。难点是替换大对象操作依赖的内部实现:预备语句会遇到名称冲突和 DISCARD 中断,PQexecParams() 则测出约 41% 的性能下降。
2026-05-26 Zhijie Hou pgsql-hackers
Zhijie Hou 在 PGConf.dev 听完 REPACK 的演讲后提交补丁,修复并发 repack 期间 WAL 文件不必要堆积的问题,演讲澄清了这种堆积属于非预期行为。Álvaro Herrera 承认这是一处疏漏,打算尽快审查并提交这个按 Chao Li 意见调整过注释的重构补丁。讨论中还提到要不要加 TAP 测试来验证操作期间 WAL 文件被正确清理,Herrera 认为略显多余,但对验证来说可能值得。
2026-05-26 Tomas Vondra pgsql-hackers
Tomas Vondra 继续审查数据校验和状态变更补丁,发现几处并发问题。备库提升过程中状态从 inprogress-on 退回 off 时,已有后端没有通过 EmitProcSignalBarrier() 收到通知,新旧连接看到的状态因此不一致。测试 012 的不确定行为则来自校验和启动器与检查点进程之间的竞态,两者交错顺序不同,最终状态就不同。他做了个用 LWLock 防竞态的原型,但不确定是否正确。
2026-05-26 Shinya Kato dev.to
Shinya Kato 列了五种容易踩坑的锁行为。ALTER TABLE 申请 ACCESS EXCLUSIVE 时排在现有锁后面,后续 SELECT 又排在它后面,建议设 lock_timeout 并盯住空闲事务。INSERT 会对被引用的父行取 FOR KEY SHARE,两个会话反序加锁就死锁。防回卷的 autovacuum 不接受取消,VACUUM 末尾的截断阶段也会短暂拿 ACCESS EXCLUSIVE。
2026-05-26 Hien Phan TigerData 博客
Hien Phan 把 PostgreSQL 的向量索引选择归结到四个约束:内存、召回率要求、写入频率和过滤条件的选择性,最优索引取决于负载而非算法优劣。文章从精确搜索讲到近似最近邻:内存够时用 HNSW,写入密集偏向 IVFFlat,数据集超出内存则考虑 DiskANN 一类做法;工具上覆盖 pgvector、pgvectorscale,以及把向量相似度与 BM25 关键词匹配结合的混合检索。作者强调真实查询往往带过滤和连接。
2026-05-26 Andrei Lepikhov pgEdge 博客
Andrei Lepikhov 写了一组 PL/pgSQL 函数给 EXPLAIN 的输出做后处理。出发点是原始输出塞了太多与平台和版本相关的细节:代价、内存分配和 worker 数量都会随硬件浮动,既让回归测试不稳定也让文档难读。pretty_explain_analyze() 直接执行查询并处理结果,内存值统一成 NN、worker 数变成 N,是否显示代价、宽度和循环次数由开关控制,默认全关。
2026-05-26 Christophe Pettus thebuild.com
AlloyDB 是 PostgreSQL 派生的查询引擎加自研分布式存储层,架构接近 Aurora,把 WAL 处理和持续清理放到存储层。特色是列式引擎,合适的分析查询能快 10 到 100 倍,但要显式物化表;索引顾问会分析查询并推荐普通与向量索引;读池提供单端点的只读扩展。默认版本是 PostgreSQL 16,扩展走白名单,托管形态不支持自定义 C 扩展。AlloyDB Omni 可以在 Google Cloud 之外跑同一引擎。
2026-05-26 EnterpriseDB EDB 博客
EnterpriseDB 的运维手册第二部分讲在 Kubernetes 上对两套由 CloudNativePG 管理的 EDB Postgres Advanced 18 集群做受控切换与回切。第一部分用 Barman Cloud Plugin 部署了副本集群,这一篇接着给出把主库职责从一个集群转移到另一个集群、再切回来的完整步骤。适用场景是地理或逻辑上分离的两套 PostgreSQL 集群之间的高可用演练和计划内切换。
2026-05-25 Richard Guo pgsql-hackers
Richard Guo 在 hackers 上指出基于外键的内连接消除存在正确性问题。这项优化假定外键约束始终成立从而重写连接,但父行删除与级联删除并非原子:在语句执行到 AFTER ROW 触发器触发之间,快照可能看到约束被违反,结果就错了。他列出六种处理方向,从放弃优化、加锁谓词到接受一个有文档记录的边缘情况。当前实现的加锁方案过于保守,会在整个事务里禁用优化;补丁将拆成优化机制与间隙处理两部分分别评审。
2026-05-25 Chengpeng Yan pgsql-hackers
连接统计信息补丁进入 v7 评审。Chengpeng Yan 提了几个设计问题:索引到底是统计定义的持久组成部分还是只在创建时需要,存在等价索引时要不要阻止 DROP INDEX;对被探测关系执行 ANALYZE 不会刷新连接统计,规划器可能同时拿到新鲜的基表统计和过时的跨关系信息。Tomas Vondra 与 Tom Lane 同意第一版只做两表连接,但目录结构要为扩展留余地;表属于不同属主时的权限问题尚未解决。
2026-05-25 Christophe Pettus thebuild.com
Christophe Pettus 建议启用 client_connection_check_interval。该参数让后端在执行查询期间轮询客户端套接字,一旦内核报告连接已断就终止查询,不再为已经消失的客户端白耗资源。默认值 0 即关闭,它依赖 POLLRDHUP,在 Linux、macOS 和 BSD 上可用而 Windows 不支持,开销只是一次系统调用。他给的经验值是 OLTP 用 10 秒,分析型长查询可以到 5 秒。
2026-05-25 Richard Yen richyen.com
Richard Yen 给出一种把外部数据用于分析的组合:外部表只当接入点,在它上面建物化视图把数据缓存到本地,再给物化视图加索引。他的判断是外部数据包装器优化的是开发体验而不是查询性能,远端延迟和不可靠的下推让性能难以预测。刷新用 REFRESH MATERIALIZED VIEW CONCURRENTLY,前提是有唯一键,代价是接受一段可控的数据陈旧。这样既避开远端系统的索引缺失与 OLTP 争用,也不必另搭一套 ETL。
2026-05-25 Postgres Pro Postgres Pro 博客
Postgres Pro 发布 Shardman 18,这是一个把数据水平分布到多个节点的 PostgreSQL 分片扩展。新版本改进了分布式查询的规划与执行,增强监控,并跟进 PostgreSQL 18 的特性。扩展在分片之间自动分布数据,同时保持 ACID 语义和跨分布式表的复杂连接能力。厂商列出的主要改进包括跨分片查询性能优化、集群管理简化和故障转移机制增强,目标是在保留标准 SQL 接口和一致性保证的前提下提供横向扩展。
2026-05-25 Slava Sarzhan Percona 博客
Slava Sarzhan 给出从 Crunchy Data 算子迁到 Percona 算子的备库方案。Percona 的算子是 Crunchy 的硬分叉,底层仍是 Patroni、pgBackRest 和 PgBouncer,迁移因此相对直接:把 Percona 集群作为现有 Crunchy 主库的备库拉起来,经备份和流复制同步,最后一步才降级旧主、提升新集群,停机很短。文中还给出以 SeaweedFS 作共享存储的配置和回滚流程。
2026-05-25 Redis GitHub Releases
Redis Open Source 8.8 正式发布,是一次功能级更新而不是补丁。新增 Array 数据结构、INCREX、XNACK 和哈希字段级通知,JSON、TimeSeries 与 Search 能力同步扩展,并带来多项性能改进。INCREX 和 XNACK 分别对应应用侧限流与流消费者的重投递恢复。生产用户升级前应验证模块与客户端兼容性、streams 待处理消息语义、限流逻辑以及 Search 和 JSON 的查询行为变化。
2026-05-25 vechron vechron.com
一份调查称发现约 900 个可公开读取的 S3 存储桶里存着 Terraform state 文件,其中 41 个含有仍然有效的 AWS 凭证。state 文件通常包含 provider 配置、资源属性、生成的凭证和内部拓扑,公开的 state 桶等于公开一张攻击路线图。这不是新型漏洞,却是云上最常见也最容易避免的问题之一。建议逐一检查各家对象存储后端的公共访问设置、桶策略、KMS 加密与访问日志。
2026-05-24 Radim Marek boringsql.com
Radim Marek 讲清了 TOAST 的机制:堆元组必须放进 8KB 页,超过约 2032 字节就触发瘦身,先压缩 EXTENDED 列,再把值挪到伴生的 TOAST 表,每块约 2000 字节,压缩可选 pglz 或 lz4。实用结论有几条:SELECT * 会把宽列全部解 TOAST;pg_column_size() 只读指针很便宜,length() 却要完整解压;改一个 1MB 的 jsonb 会重写全部分块。
2026-05-24 Andrei Lepikhov danolivo.substack.com
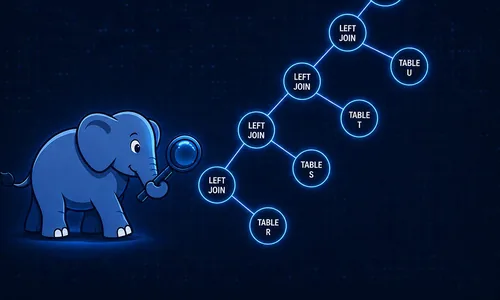
Andrei Lepikhov 讨论 ORM 常见的多态关联:一列要指向多张互不相关的表,通常用类型加 id 的判别式外键,再用一串带类型条件的 LEFT JOIN 还原。问题出在规划器:连接链上的选择率误差会逐级相乘放大,当 join_collapse_limit 被突破、EXISTS 子查询没能放到合适位置时,基表行要走完整条 LEFT JOIN 链才被过滤。作者说这篇先界定问题,后续再给优化器改法。
2026-05-24 Christophe Pettus thebuild.com
Christophe Pettus 的 GUC 系列讲到 client_encoding:它声明客户端使用的字符编码,默认跟随服务端编码。两端不一致时,来往的每个字符都要过一次转换表,目标编码放不下某个字符就直接报错。常见的三类麻烦是默认值不匹配导致老数据报错、SQL_ASCII 库完全关掉编码校验,以及跨编码的转储恢复。他的建议是别在服务端配置里设它,交给 libpq 协商,确需非 UTF-8 编码时在连接串或角色级别指定。
2026-05-24 Christophe Pettus thebuild.com
Christophe Pettus 更正了此前关于 Snowflake Postgres 的推断:它就是社区版 PostgreSQL,不是带专有存储层的分支,之前对 table access methods 的猜测也不成立。更正本身的价值在于提醒读者,号称 Postgres 兼容的产品差别极大:有的是真 PostgreSQL,有的只是协议兼容,有的是分支。评估时应问清版本来源、扩展支持、系统目录行为、WAL 与备份语义和迁移退出路径。
2026-05-24 Tom Lane、Peter Eisentraut pgsql-hackers
有人提议把 PostgreSQL 的版本号从顺序编号改为年份,比如 19 改叫 2026。Tom Lane 反对,认为这会给发布计划套上不必要的约束:原定 2027 年发布的版本若延到 2028,后面的周期都会被打乱。Peter Eisentraut 补充说,很多产品在某年年底发布却按下一年的版本号做营销,年份并不能消除歧义。Philip Alger 则担心 12 月发布的版本几周后就显得过时,用户会因版本号的年代感而非实际需要去升级。
2026-05-22 ClickHouse ClickHouse 博客
ClickHouse 把 Rust 写的 Delta Kernel 集成进来,用于读取 Delta Lake 表。湖仓格式的难点不在读 parquet,而在事务日志、schema 演进、版本语义和写入一致性;各引擎各自实现协议容易产生偏差,直接接入共享 kernel 能减少这类分歧。对用 ClickHouse 查询 Delta Lake 的团队,值得关注新实现的兼容性与性能差异,写入、时间旅行和 schema 演进最好单独压测。
2026-05-22 GitHub GitHub Changelog
GitHub 让 npm 的 staged publishing 正式可用,并新增安装期的来源控制选项。改动针对的是发布与安装的安全模型,而不是某个具体漏洞:staged publishing 把发布前的验证前置,来源白名单则限制本地路径、git URL、link 等安装方式被滥用。发布 npm 包的团队可以把它加进发布清单,JavaScript 项目可以在 CI 里收紧安装来源策略。
2026-05-23 Paolo Melchiorre paulox.net
Paolo Melchiorre 记录了在 Ubuntu 26.04 上把 PostgreSQL 17.10 升到 18.4 的过程,用的是发行版自带工具,不依赖 PGDG 仓库。核心是一条 pg_upgradecluster 17 main -v 18:新集群接管 5432,旧集群退到 5433 并停止,确认无误再 pg_dropcluster 并卸载 17 的软件包。文中没有涉及扩展兼容与备份,这些仍需自行安排。
2026-05-23 Amit Kapila、Álvaro Herrera pgsql-hackers
为支持并发 REPACK,补丁引入了数据库级快照。Amit Kapila 提出架构层面的担忧:逻辑解码从设计上处理的是集群范围的事务,而这个补丁在构建初始快照时绕开了该假设。他认可库级快照对并发 repack 的价值,但认为需要更多时间评估它与既有机制的相互作用。Álvaro Herrera 考虑到 beta 1 前的时间压力,同意先在 PostgreSQL 19 里回退这部分功能,放到 20 再做。
2026-05-23 Shinya Kato pgsql-hackers
autovacuum 清不掉死元组时,DBA 往往要另行排查是谁按住了 xmin 水位。Shinya Kato 的补丁让日志直接给出最旧 xmin 的来源。同一个 xid 只可能属于一个后端,因此 active、idle、prepared 之间怎么排序都不影响结果;设计上只报告优先级最高的那个阻塞者,避免日志冗长、便于定位根因。完整的阻塞者列表计划以后通过动态统计视图暴露,审阅者反馈积极。
2026-05-23 Xuneng Zhou pgsql-hackers
Alexander Lakhin 报告 019_replslot_limit.pl 因新的 WAIT FOR LSN 实现而失败:wait_for_catchup() 现在在备库回放到目标 LSN 时就返回,不再等主库处理完反馈并更新槽状态,测试检查时 restart_lsn 还没推进。Xuneng Zhou 判断新语义更正确,该改测试。Alexander Korotkov 建议直接调用 wait_for_slot_catchup()。
2026-05-23 Christophe Pettus thebuild.com
Christophe Pettus 的 GUC 系列继续讲检查点。checkpoint_flush_after 提示内核在检查点期间把脏页逐步刷盘,Linux 上默认 256kB,其他平台为 0,作者说这是最不需要动的参数。checkpoint_warning 默认 30 秒,WAL 量触发的检查点过于频繁时在日志里告警,真出现告警应该调大 max_wal_size。
2026-05-22 Christophe Pettus thebuild.com
pgvector 0.8.2 修复了并行 HNSW 索引构建中的堆缓冲区溢出,编号 CVE-2026-3172。并行构建靠共享内存协调多个 worker,缓冲区一旦越界就会写进相邻区域,一个用户的构建可能读到或损坏另一个后端的内存,后果是数据泄露或实例崩溃。Christophe Pettus 建议部署后执行 ALTER EXTENSION pgvector UPDATE,不必重建索引。托管服务常落后上游,值得先确认实际版本。
2026-05-22 Greg Burd GitHub
Greg Burd 发布 pg_mentat 1.3.0,在 PostgreSQL 内部实现 Datomic 的数据模型:不可变事实 datom、schema 优先的属性体系、Datalog 查询编译器、时间旅行和 ACID 事务。项目用 Rust 与 pgrx 0.17 构建,支持 PostgreSQL 13 到 18。这一版新增一批 Datalog where-fns,可把 pg_trgm、pgvector 等扩展作为软依赖桥接。
2026-05-22 Greg Burd PostgreSQL 新闻
pg_infer 1.0.0 面向 PostgreSQL 18+,把小型 Transformer 模型的内部知识以 SQL 关系暴露出来,并配自定义索引访问方法。作者 Greg Burd 强调它不是自然语言转 SQL,没有聊天界面和 agent 循环,而是把模型推理做成查询计划里的算子,交给规划器估算代价与并行。模型存放在 WAL 页面中,可随数据一起备份复制;推理面向 CPU 优化并支持 BitNet,目标是用上空闲副本的算力。
2026-05-22 Shaun Thomas pgEdge 博客
Shaun Thomas 梳理了透明数据加密迟迟进不了 PostgreSQL 的原因:社区在威胁模型上没有共识,防磁盘失窃有 LUKS,防恶意 DBA 靠服务端加密根本做不到,剩下的多半是合规诉求。实现范围要覆盖缓冲区管理、WAL、临时文件、复制和备份工具,密钥管理本身又自相矛盾。从 2016 年 Ants Aasma 到 Peter Eisentraut 的透明列加密,四轮补丁都停在讨论里,几家厂商各有互不兼容的闭源实现。
2026-05-22 Jake Hertz TigerData 博客
Jake Hertz 讨论双重缓冲:同一批数据块同时留在 shared_buffers 和操作系统页面缓存里,既浪费内存,在写密集负载下还拖慢性能。文章给出的经验值是 shared_buffers 取总内存的 25%,512GB 以上的机器限制在 128GB 到 256GB,另需同步调整 effective_cache_size。诊断可用 pg_buffercache 看哪些表占满缓冲区,单个对象超过 30% 就该考虑分区。
2026-05-22 Umair Shahid Stormatics 博客
Umair Shahid 复盘了一次逻辑复制迁移事故:11TB 大表的 COPY 让快照开了几个小时,autovacuum 的清理水位被钉住,与之无关的任务队列表堆出几百万死元组。索引随之膨胀,取任务的查询延迟越过一秒,队列 12 小时内积压到 700 万行;临时缓解后 worker 又挤在热索引页上,multixact 缓冲区的轻量锁成了新瓶颈。改进是迁移前评审数据量与写入速率,对超龄事务和死元组告警,并单独控制队列表的快照时长。
2026-05-20 AWS AWS 数据库博客
AWS 数据库博客介绍开源项目 ExtendDB:实现 DynamoDB 的 wire protocol,存储后端可插拔,第一个参考后端就是 PostgreSQL。官方说明 v0.1 只适合开发、测试和实验,不是托管服务的成熟替代品。这类兼容层的价值在本地开发、CI、边缘和离网环境,也让 PostgreSQL 多了一个充当兼容控制面的角色。试用时重点验证条件写入、事务、streams、SigV4 和灾备语义与托管版的差距。
2026-05-21 FreeBSD FreeBSD 安全公告
FreeBSD 发布 FreeBSD-SA-26:18.setcred,修复 setcred 系统调用中的内核栈溢出,对应 CVE-2026-45250,研究者称之为 FatGid。受影响的 14.x 与 15.0 应分别升级到 14.3-RELEASE-p14、14.4-RELEASE-p5 和 15.0-RELEASE-p9。这是本地提权而非远程执行,但多用户 shell、CI runner 和共享构建机的用户边界假设会直接失效。
2026-05-20 AWS AWS What's New
AWS 发布 ExtendDB 0.1,一个 Apache 2.0 许可的 DynamoDB API 兼容适配器,第一个参考存储后端是 PostgreSQL。它面向不能使用托管 DynamoDB 的场景,目标是应用代码不改写就能在本地、CI、自建机房或断连的边缘环境里跑 DynamoDB 形态的负载,对 PostgreSQL 生态来说是又一个把 Postgres 当作兼容后端的案例。有这类需求的团队可以关注它的兼容范围、事务语义与运维边界。
2026-05-21 Christophe Pettus thebuild.com
Christophe Pettus 再次提醒 PostgreSQL 核心的 CVE-2026-6473:官方评分 CVSS 8.8,是整数回绕导致的越界写入,18、17、16、15、14 各分支未修复的版本都受影响,修复已随 18.4、17.10、16.14、15.18 与 14.23 发布。这类问题不像扩展漏洞可以靠回收权限缓解,只能升级。仍在旧小版本上的实例应把升级排进本周维护窗口,托管实例也要确认厂商是否已推送。
2026-05-21 pg_statviz 项目 GitHub
pg_statviz 把 PostgreSQL 内部统计做成时序分析与可视化,1.0 的主要变化是可选的 AI 分析:加上 --ai 之后,每张图的数据与图片会送给有视觉能力的模型,给出 HEALTHY、WARNING 或 CRITICAL 判断、简短解读和改进建议,可选 Claude、Gemini 或本地 Ollama。流程先跑确定性的规则引擎再调用模型,最终结论不会低于规则引擎的级别。不启用 AI 时工具没有额外依赖。
2026-05-20 GitHub GitHub 博客
GitHub 发布事件说明:5 月 18 日一名员工的设备因第三方被投毒的 VS Code 扩展失陷,目前评估是 GitHub 内部仓库遭到窃取,攻击者声称约 3800 个仓库,与调查方向一致。官方称没有证据显示客户的企业、组织和仓库受影响,已按优先级轮换关键密钥,并继续分析日志、验证轮换结果。供应链攻击从装包、CI 与发布令牌进一步推进到 IDE 扩展,而扩展通常能读工作区、环境变量与本机凭证,权限边界很宽。
2026-05-21 CNCF CNCF
CNCF 宣布 OpenTelemetry 毕业,确认它作为云原生可观测性事实标准的地位。这条消息的分量不在某个功能,而在于一层基础设施标准进入成熟期:追踪、指标、日志与性能剖析的采集语义收敛之后,观测数据可以在不同后端之间迁移,供应商锁定随之下降。数据库、Kubernetes、服务网格、模型推理与无服务器平台都在围绕它做埋点与采集管线。新系统应优先采用它的 SDK、Collector 与语义约定。