在运行的集群上开关数据校验和的补丁重启评审
让运行中的集群在线开启或关闭数据校验和,是悬了多年的需求。Daniel Gustafsson 把补丁集重新基于主线:代码挪进重命名后的 datachecksumsworker,信号处理改写,补上 PITR 与整页写的测试,状态切换处引入检查点。Tomas Vondra 评审指出三处问题:注入点可能改不到数据库列表,遍历数据库时记录进度有误,失败的库应立即中止而不是继续。他还提醒,新增 XLOG 记录类型如今需要第二个资源管理器。
pgsql.cc 提供对 postgresql.org 官网内容的中文翻译,由 Pigsty 团队维护。
每日精选 PostgreSQL、数据库与云计算资讯
让运行中的集群在线开启或关闭数据校验和,是悬了多年的需求。Daniel Gustafsson 把补丁集重新基于主线:代码挪进重命名后的 datachecksumsworker,信号处理改写,补上 PITR 与整页写的测试,状态切换处引入检查点。Tomas Vondra 评审指出三处问题:注入点可能改不到数据库列表,遍历数据库时记录进度有误,失败的库应立即中止而不是继续。他还提醒,新增 XLOG 记录类型如今需要第二个资源管理器。
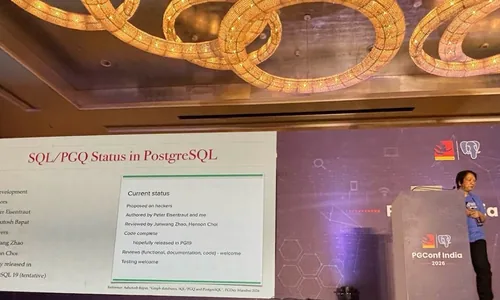
PostgreSQL 开发者 Ashutosh Bapat 写了一篇随笔,说职业工作也有因果:不负责任的实现会反噬自己和他人,扎实的贡献则会在意想不到的地方回到生活里。他举了三件事:职业早期某金融机构系统的一个缺陷,让包括他本人在内的多个银行账户无法使用;如今在车站扫码买票取代了当年排的长队,背后跑的正是 PostgreSQL;他参与实现的 SQL/PGQ 图查询,被人用来改进咖啡供应链。职业焦虑常常遮住了工作更大的那层意义。
用外部服务器定义代替连接串,评审集中在目录字段对齐、pg_dump 覆盖和两种模式切换的测试。
第 3 版只对超过一个向量长度且无需转码的值走 SIMD,干净数据快 34–39%,宽表回到 ±4%。
为赶上 19 版特性冻结,libpq 故障仍按错误处理;reltuples 为 0 或 -1 时跳过列统计。
Jelte Fennema-Nio 补回遗漏文件并修好 CI 失败,目标是让扩展对象获得更强的隔离。
协议 grease 改动引发的失败已绕开,macOS 上 UNIX 套接字临时路径过长的问题一并修掉。
Pavel Luzanov 梳理了 2025 年 11 月 CommitFest 进入 PostgreSQL 19 的改动。规划器方面有急切聚合、COUNT 优化和并行 TID Range Scan,分区表 COPY 也更快。新特性包括 error_on_null、符合 SQL 标准写法的临时对象函数,以及让副本等待主库位点的 WAIT FOR。监控侧新增复制槽内存计数器、缓冲区分布统计和单表统计重置时间。
PostgreSQL 的维护设计假设负载存在安静期,批量 ETL 之间会留出清理窗口。IoT 传感器、交易流和指标采集这类不间断写入抹平了窗口,于是三件事同时发生:autovacuum 一直在跑并与写入争抢 I/O,检查点在 WAL 里制造连续的整页写突发,ANALYZE 的统计更新也与摄入互相干扰。WAL 因此成为吞吐上限,按作者测算每次插入连同索引会产生 2.5–3.5KB 的 I/O。加 worker 或换更快的存储只能推迟问题。
宽 CSV 数据在 ARM 上快 42–61%、x86 上快 49–61%,已在 RISC-V、SPARC、ARM 上验证可用。
含基础复制、同步 worker 的序列缓存与 REFRESH SEQUENCES 直接同步,LSN 更新逻辑仍有疑点。
症状是 xlog flush request is not satisfied,修复方案是新增 GetXLogInsertEndRecPtr()。
Alexander Lakhin 定位到提交 82467f627 引入的缺陷,Andres Freund 已认领修复。
冲突条目可能因惩罚变化和页面分裂落在别的叶页,作者已把状态改回 Waiting on Author。
只保留 0001,用于监控 VM 变动、发现 DML 倾斜和评估 IndexOnlyScan;0002、0003 大概率不进 PG19。
PostgreSQL 社区协会(PGCA)是核心团队在 2011 年授权成立的非营利组织,负责持有并保护 PostgreSQL 的商标与品牌资产。协会参考其他开源基金会的赞助模式,考虑到维护品牌资产的成本上升,自 2026 年 2 月 1 日起上调 Benefactor 与 Patron 两个最高等级的赞助额度,其余等级维持不变。同期上线改版后的官网,把非营利使命、商标使用规范和捐赠入口集中呈现,域名仍是 postgres.ca。
软删除表的常见写法是 EXISTS 配活跃行的部分索引。Nikolay Samokhvalov 对比两个等价查询:一个用 EXISTS 匹配占 98% 的活跃帖子,另一个把 not 挪进子句,用 NOT EXISTS 匹配占 2% 的已删除帖子。后者快 32 倍。原因是索引里「没找到」可以完全跳过堆访问,而「找到了」在频繁更新的表上还要回表校验可见性:前者做了 52.7 万次堆读取,后者 1 万次。凡少数派布尔标记的模式都适用这个思路。
Matty Stratton 从写放大的角度解释索引为何反噬写入:一张带 5 个索引的表每插入一行要落 6 次写,1 次堆写加 5 次索引写,在 5 万行每秒的摄入速率下就是每秒 30 万次写,带来大量 I/O 与 WAL 膨胀。时间戳这类单调递增列还有「热右边缘」问题,B-tree 最右侧叶页持续分裂。由此形成回路:索引拖慢写入,缓冲区压力上升,查询变慢,于是再加索引。每秒 500 行时无碍的索引数量,到 5 万行每秒就成了问题。
Lukas Fittl 反对把 AI 包装成 DBA 的替代品。他认为这种说法混淆了「执行工作」与「对结果负责」两件事,生产出问题时模型无法担责,团队反而留下一段责任真空。他主张换个方向用 AI:不去替换数据库专家,而是由平台团队提供安全、经过筛选的 AI 工具,帮应用工程师和数据平台团队更有效地使用数据库。LLM 擅长的是检索资料、交叉引用代码、弥合团队之间的知识差距,生产决策的归属和问责仍要落在人身上。
Andres Freund 的补丁减少争用缓存行上的原子操作,索引嵌套循环连接最多快 25%。
语法为 FOR ALL TABLES EXCEPT TABLE (a, b, c),括号写法与现有包含列表是否一致仍有争论。
两边正确性相同,匹配失败时 PostgreSQL 保持 O(n),Trino 呈 O(n²),10 万行时差距悬殊。
Jeff Davis 主张默认 UTF-8,C 排序建索引快 3 倍、排序快 2–5 倍,但 19 版赶不上。
Nathan Bossart 用新 GUC 调节各项权重,越过 failsafe 年龄的表评分高到千万亿量级。
Melanie Plageman 移除 get_conflict_xid(),冲突 XID 只按设置 VM 位、冻结、修剪三种情况计算。
hash、gin、bloom_vacuum 收益微小;Andres Freund 要求换用缓冲区驱逐函数重测。
电网优化公司 Plexigrid 把原本由 InfluxDB、TigerGraph、MySQL 和 PostgreSQL 拼成的架构合并为一套 TimescaleDB,用于配电网的近实时监控。厂商给出的迁移结果是摄入速度提升 44%,存储占用下降 95%,查询性能提升 350 倍。更实际的收益是部署简化:同一套架构覆盖云端和本地环境,运维不必再为四种存储各准备一套流程。数据出自客户案例,负载特征是否相符需自行判断。
jsonb 给了 PostgreSQL 存放半结构化数据的灵活性,却没有内置的结构校验;用 CHECK 约束加 SQL 自己写校验逻辑,稍复杂就难以维护。EDB 介绍了一个名为 json_schema_validate 的扩展,直接在数据库内按 JSON Schema 规范校验 json 与 jsonb 数据。它的价值在于把校验规则写成一份标准的 Schema,而不是散落各处的约束表达式,既拦住坏数据,又保留 jsonb 本身的灵活。
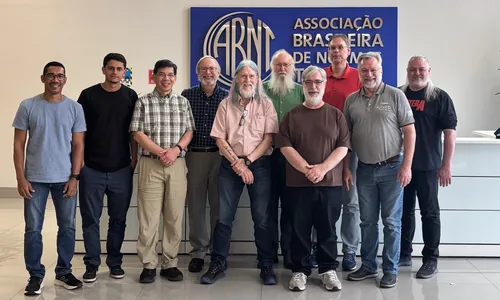
EDB 的 Matheus Alcantara 与 Euler Taveira 作为受邀嘉宾参加了在圣保罗举行的 ISO/IEC SQL 标准委员会会议,Peter Eisentraut 远程参与。两人把标准化流程类比成 PostgreSQL 的 Commitfest,提案提交、讨论、打磨的节奏相似。这类参与的意义在于 PostgreSQL 社区不只是跟随标准,也能对语言演进的方向出声,标准与实现之间的差异往往就在这样的会议上被讨论掉。
表和索引 AM 直接控制批次布局,位图索引扫描 5% 的回归已修复,缓冲区 pin 归谁释放仍有分歧。
填充里可能带上服务器内存内容,提出者认为风险类似 Heartbleed,也挡住了 MemorySanitizer 的采用。
定义这类函数需要超级用户权限,讨论认为除了核对 C 函数签名,没有现实可行的运行时防护。
Nathan Bossart 指出回归来自需要转义的列上反复调用 strlen(),可能要在转义时跳过 SIMD 路径。
Peter Geoghegan 想扫两三个索引叶页面就放弃,Andres Freund 担心回滚批量插入后的估算变差。
工业物联网的数据库负载有几个同时成立的要求:持续高速摄入、长期保留,还要既支撑跨传感器的宽查询,也支撑单传感器的深查询。这篇文章把 PostgreSQL 在这类场景下的上限归纳成三条约束:存储成本随时间接近二次增长,最大摄入速率随索引增加而下降,查询性能随数据量增加而下降。可选的出路是加硬件、分片,或用 TimescaleDB 这类工具靠自动分区和混合存储优化时序负载。文章的实际用处是给概念验证阶段的容量估算提供一个框架。
Anthropic 与 Mozilla 的一次安全合作中,Claude 在两周测试期内在 Firefox 里找出 22 个独立漏洞,其中 14 个被归为高危。报道没有列出具体的漏洞编号和受影响版本,也没有说明这些问题是否已经修复发布。对安全团队来说,值得关注的是这类工具在大型 C++ 代码库上的实际命中率,以及由此产生的报告如何进入既有的分级和修复流程:模型发现的问题同样需要人工确认和回归验证。
每页只有一个元组的最坏情况下性能有下降,但合并 WAL 记录之后 vacuum 明显更快。
Michael Paquier 提交后补上备库测试,wal_source 列拟改名为 wal_read_source 以免歧义。
ALTER PUBLICATION 用 SET ALL TABLES EXCEPT TABLE (t1) 设排除列表,只写 SET ALL TABLES 清空。
新增 ExecutorPrep() 让加锁跟随修剪结果,避免 GetCachedPlan() 提前锁住全部分区。
不再整个交换 SSL_CTX,改为在 clienthello 回调里按主机重新配置同一个主上下文。
虚拟化环境里 CPU 频率不等于 TSC 频率,讨论倾向用几十毫秒的校准循环取代读 MSR。
pgAdmin 团队发布 v9.13,共 15 项修复与新功能。最显眼的是引入核心 LLM 集成基础设施,在此之上提供安全、模式与性能方面的 AI 报告、查询工具里的 AI 聊天,以及 EXPLAIN 的 AI 解读。此外 ERD 工具会显示由现有表生成的关系图中的外键关系,索引创建对话框支持 ONLY,建表时可自定义 OF TYPE 列,也能从 JSON 文件加载预定义用户。修复覆盖结果集下载忽略引用设置、工具设置重启后丢失等问题。
表分区常被当作 PostgreSQL 扩展性的默认答案。这篇文章把代价摊开讲:分区裁剪确实让窄时间范围的查询和按分区 DROP 的数据保留变快,但写入性能并不改善,长跨度查询的规划时间随分区数量线性增长,季度报表和历史分析首当其冲。运维面同样变大,自动建分区一旦静默失败就会出事,监控和操作手册都要按分区改写。作者的结论是分区适合保留期可预测的中等写入负载,对高频摄入只是把问题往后推,MVCC 的开销并没有消失。
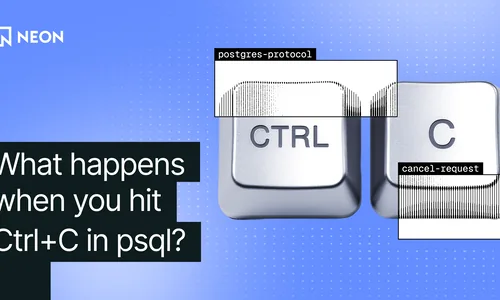
在 psql 里按 Ctrl-C 中止一条跑太久的查询,是很多人每天都会做的动作。Neon 的 George MacKerron 写文章说明这个操作为什么让他不安:中止的场景各不相同,有时是发现该先建索引,有时是结果已经不需要,而取消请求要经过一条与查询本身无关的路径,是否生效、何时生效并不总是确定。文章梳理了这一过程中的技术细节和可能出问题的地方,也解释了这个常见动作值得多一分谨慎的理由。
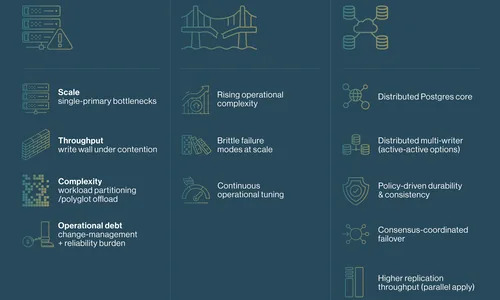
EDB 发文讨论 PostgreSQL 服务上亿用户时遇到的写入瓶颈,把单主架构的上限称作 write wall,认为绕过它的常见做法会积累人工干预和运维债务。文章给出的方案是 EDB Postgres Distributed,用原生的双活架构替代分库分表和多种数据库拼装的组合,官方口径称它能自愈并支撑大规模负载。内容属于厂商视角,PGD 是商业产品,双活带来的冲突解决语义和应用改造成本文中没有展开,评估时需要自行验证。
heap_update 等函数改了 VM 缓冲区却不写进 WAL 记录,增量备份会拿到过时的 VM,vacuum 随后报不一致。
序列不再一次性同步,改为在发布端与订阅端之间持续对齐,并用漂移检测避免无谓的同步。
会议 6 月 25 至 26 日在 Rapperswil 举行,演讲征集 4 月 7 日截止,海报 6 月 8 日前提交。
计划不稳定是 PostgreSQL 长期缺少直接手段的问题。Robert Haas 撰文介绍他为 PostgreSQL 19 提交的补丁集,包含三个新的 contrib 模块:pg_plan_advice 定义计划建议的表达方式,pg_collect_advice 从已执行的查询里收集建议,pg_stash_advice 按查询 ID 匹配并覆盖计划。目标是让用户不改写 SQL 也能获得计划稳定性。作者也说不确定这组补丁能否赶上 19。
上百台构建机报错,Tom Lane 主张回退,最后折中为只在 --with-lz4 构建时把 lz4 设为默认。
Amit Kapila 推送了第 56 版,逻辑复制的 ALL TABLES 发布从此可以排除掉指定的表。
错误级别从 ERROR 降为 LOG,等备库追上主库再继续,重试只针对处于临时状态的槽位。