PostgreSQL 减少备用库回放的多余清理锁
PostgreSQL 已合入一项备用库回放修复:只冻结元组或更新可见性映射的 WAL 记录,不再无条件申请清理锁。旧行为会等待其他进程释放缓冲区引用,即使记录并未移动或删除元组,也可能拖慢恢复并取消备用库上的查询。补丁把清理锁限定到真正执行页面修剪的记录,提交注明回补至 PostgreSQL 17;可见性映射的额外受影响路径从 19 起出现。这有助于减少分析查询与恢复进程之间不必要的冲突,已合入的修复仍需等待相应版本发布。
pgsql.cc 提供对 postgresql.org 官网内容的中文翻译,由 Pigsty 团队维护。
当天收录 26 条。
PostgreSQL 已合入一项备用库回放修复:只冻结元组或更新可见性映射的 WAL 记录,不再无条件申请清理锁。旧行为会等待其他进程释放缓冲区引用,即使记录并未移动或删除元组,也可能拖慢恢复并取消备用库上的查询。补丁把清理锁限定到真正执行页面修剪的记录,提交注明回补至 PostgreSQL 17;可见性映射的额外受影响路径从 19 起出现。这有助于减少分析查询与恢复进程之间不必要的冲突,已合入的修复仍需等待相应版本发布。
PostgreSQL 开发分支为 pg_upgrade 增加数据类型检查,阻止含有特定系统类型数组的用户表直接升级。数组值保存元素类型的 OID,而部分系统类型及 information_schema 域的标识可能跨大版本变化;升级工具不重写用户数据,旧值随后可能报类型查找失败,甚至被按错误类型解读。新检查提前列出问题列,要求删除或转换类型后重试。提交说明该场景较少见,暂未回补;这是升级前的数据完整性保护,并非对已升级数据的自动修复。
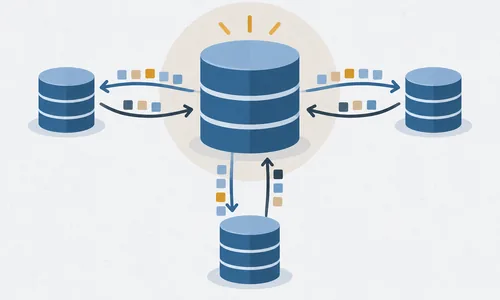
Dimitri Fontaine 用可重现的中心库与工作库示例,梳理 PostgreSQL 原生逻辑复制逐版消除的应用限制:中心库向各工作库分发必要的参考数据,工作库再把事件汇总回来。文章把行列过滤、复制标识、大事务流式传输及防止复制循环放到同一架构中,说明过滤列与复制标识必须配合,分散写入还要单独设计全局唯一键。示例同时划清原生功能边界:DDL 仍需另行迁移,冲突记录也不等于自动解决冲突。涉及 19 的序列复制明确属于测试版能力。
一次性执行的 SQL 即使成功,也未必长期留在 pg_stat_statements 中。Mikhail Shytsko 的实验展示了大量不同查询形状挤出低频写操作的过程,并解释统计视图按角色、数据库与查询标识等聚合,无法仅凭应用名区分共用账号的调用方。默认只追踪顶层语句,函数内语句与失败操作还存在其他可见性边界。排障时应观察淘汰计数、为调用方分配角色,并结合带身份信息的日志;扩大统计容量可以缓解淘汰,却不能把聚合统计变成持久审计记录。
AWS 分析了大型 Kafka 消费组反复再均衡的一条隐蔽路径:协调器写入内部位点主题的组元数据,可能随成员、订阅与名称长度增长,超过记录大小限制。提高业务消息上限并不能直接解决这个内部主题的问题,还必须协调主题记录上限与副本拉取上限,避免复制落后。文章同时讨论拆分消费组、限制自动扩容规模和缩短命名带来的取舍。调大限额会增加代理处理再均衡时的堆内存压力,因此需要连同垃圾回收、复制健康与消费进度一起验证。
同一 URL 按语言或格式返回不同内容时,缓存既要避免串用响应,也要防止请求头的细微差异制造大量冷缓存。Cloudflare 将 Vary 支持加入所有套餐的缓存规则,允许按请求头选择归一化、原值匹配或绕过缓存,并把归一化后的部分协商头传给源站,保持缓存选择与源站行为一致。源站仍须稳定声明正确的 Vary 字段;个性化或高基数请求头适合绕过缓存,Vary: * 始终绕过。修改配置不会自动清理旧缓存,发布时仍需验证各变体并按需清除内容。
提高锁粒度精度可减少误报的可串行化冲突,却会更快消耗固定锁表;仅提高页面阈值还可能提前触发表级升级。
Now-Next 实测指出,逐租户模式会放大备份锁表需求,共享表则须自行覆盖租户导出与外键索引。
计划切换前核验故障转移槽并等待就绪;配置不合格先阻止切换并告警,宽限期后仍会放行,运维需及时修正。
案例用集中启动器与事件总线统一运行,并按输入分区生成合并条件,减少 Athena 扫描量与历史重跑差异。
Unused 条件及状态转换时间可定位闲置卷;尚未调度的 Pod 仍算使用者,已结束的 Pod 则不再占用。
1.37 的 Beta 功能默认关闭,允许主容器独占资源、边车共享 Pod 内资源池,无需让每个容器独占核心。
代码、配置、观测及 Durable Objects 状态按预览隔离;D1、R2、KV 等账号级资源仍需绑定独立实例。
AWS 开源方案把授权条件用于工具可访问的数据对象,弥补仅允许调用工具却未限制其读取哪些数据的缺口。